4 Capa de red
La capa de red es el segundo nivel del modelo de capas TCP/IP y forma el núcleo del sistema de comunicaciones de Internet. Su principal función es proporcionar una comunicación end-to-end entre dispositivos, potencialmente separados por múltiples redes intermedias, independientemente de la tecnología subyacente. Es decir, la comunicación funciona de igual forma si estamos conectados a través de WiFi, Ethernet o 5G, a pesar de que sean diferentes medios. Esta clara delimitación de capas permite combinar de forma más sencilla diferentes tecnologías y dispositivos hardware.
Como es habitual, vamos a ver un ejemplo simplificado donde un dispositivo quiere mandarle un mensaje a otro dispositivo que no está en la misma red. Este ejemplo simula una situación real como acceder desde casa a un servidor web de Google. Habrá conceptos que no os suenen pero los veremos a lo largo del capítulo. El dispositivo A (tu ordenador en casa), con IP (192.168.1.10) quiere enviarle un mensaje al dispositivo B (servidor web de Google), con IP (142.250.184.3). Durante el ejemplo vamos a realizar una simplificación y utilizaremos siempre la IP del emisor como 192.168.1.10, pero esto no es válido como veremos posteriormente ya que se trata de una IP privada y el Router-A utilizaría NAT. La estructura de la red es la siguiente:
Red A (Privada)               Internet             Red B (Google DC)
192.168.1.0/24                                      142.250.184.0/24
┌────────────┐ ┌───────────────┐   ┌─────────────────┐ ┌─────────────┐
│   Host A   │─│   Router-A    │─*─│    Router-B     │─│ Servidor Web│
│            │ │    (Casa)     │   │   (Google DC)   │ │   (Google)  │
│192.168.1.10│ │LAN:192.168.1.1│   │WAN:74.125.24.1  │ │             │
│            │ │WAN:203.0.113.2│   │LAN:142.250.184.1│ │142.250.184.3│
└────────────┘ └───────────────┘ └─────────────────┘ └─────────────┘Los pasos de los que constaría este ejemplo simplificado están recogidos en la Figura 4.2 y serían los siguientes:
El dispositivo A (192.168.1.10) examina la IP de destino (142.250.184.3). La IP 142.250.184.3 no está en mi red 192.168.1.0/24, por lo tanto enviará el paquete al gateway (192.168.1.1), es decir, el Router-A. Para ello obtiene la MAC del Router-A y le envía la trama.
El Router-A recibe la trama. Ve que la MAC de destino coincide con la suya y extrae el datagrama IP. Lee la IP de destino (142.250.184.3), y como no está en su red local, consulta su tabla de enrutamiento. Determina que debe enviar el paquete a su router del ISP (203.0.113.1). Este router del ISP tendrá en su tabla de enrutamiento una entrada que indica que para llegar a la red 142.250.184.0/24 debe enviar los paquetes al router 74.125.24.1. Router-A actualiza los campos necesarios del datagrama IP y lo encapsula en una nueva trama.
El Router-B (74.125.24.1) recibe la trama después de múltiples saltos a través de Internet, extrae el datagrama IP y lee la IP de destino (142.250.184.3). Consulta su tabla de enrutamiento y determina que la red 142.250.184.0/24 está directamente conectada a través de su interfaz 142.250.184.1. Router-B obtiene la MAC del servidor web y le envía el paquete.
Finalmente, el servidor web recibe la trama, ve que la MAC de destino es suya, extrae el datagrama IP, comprueba que la IP de destino (142.250.184.3) coincide con la suya, y entrega los datos al protocolo de la capa superior.
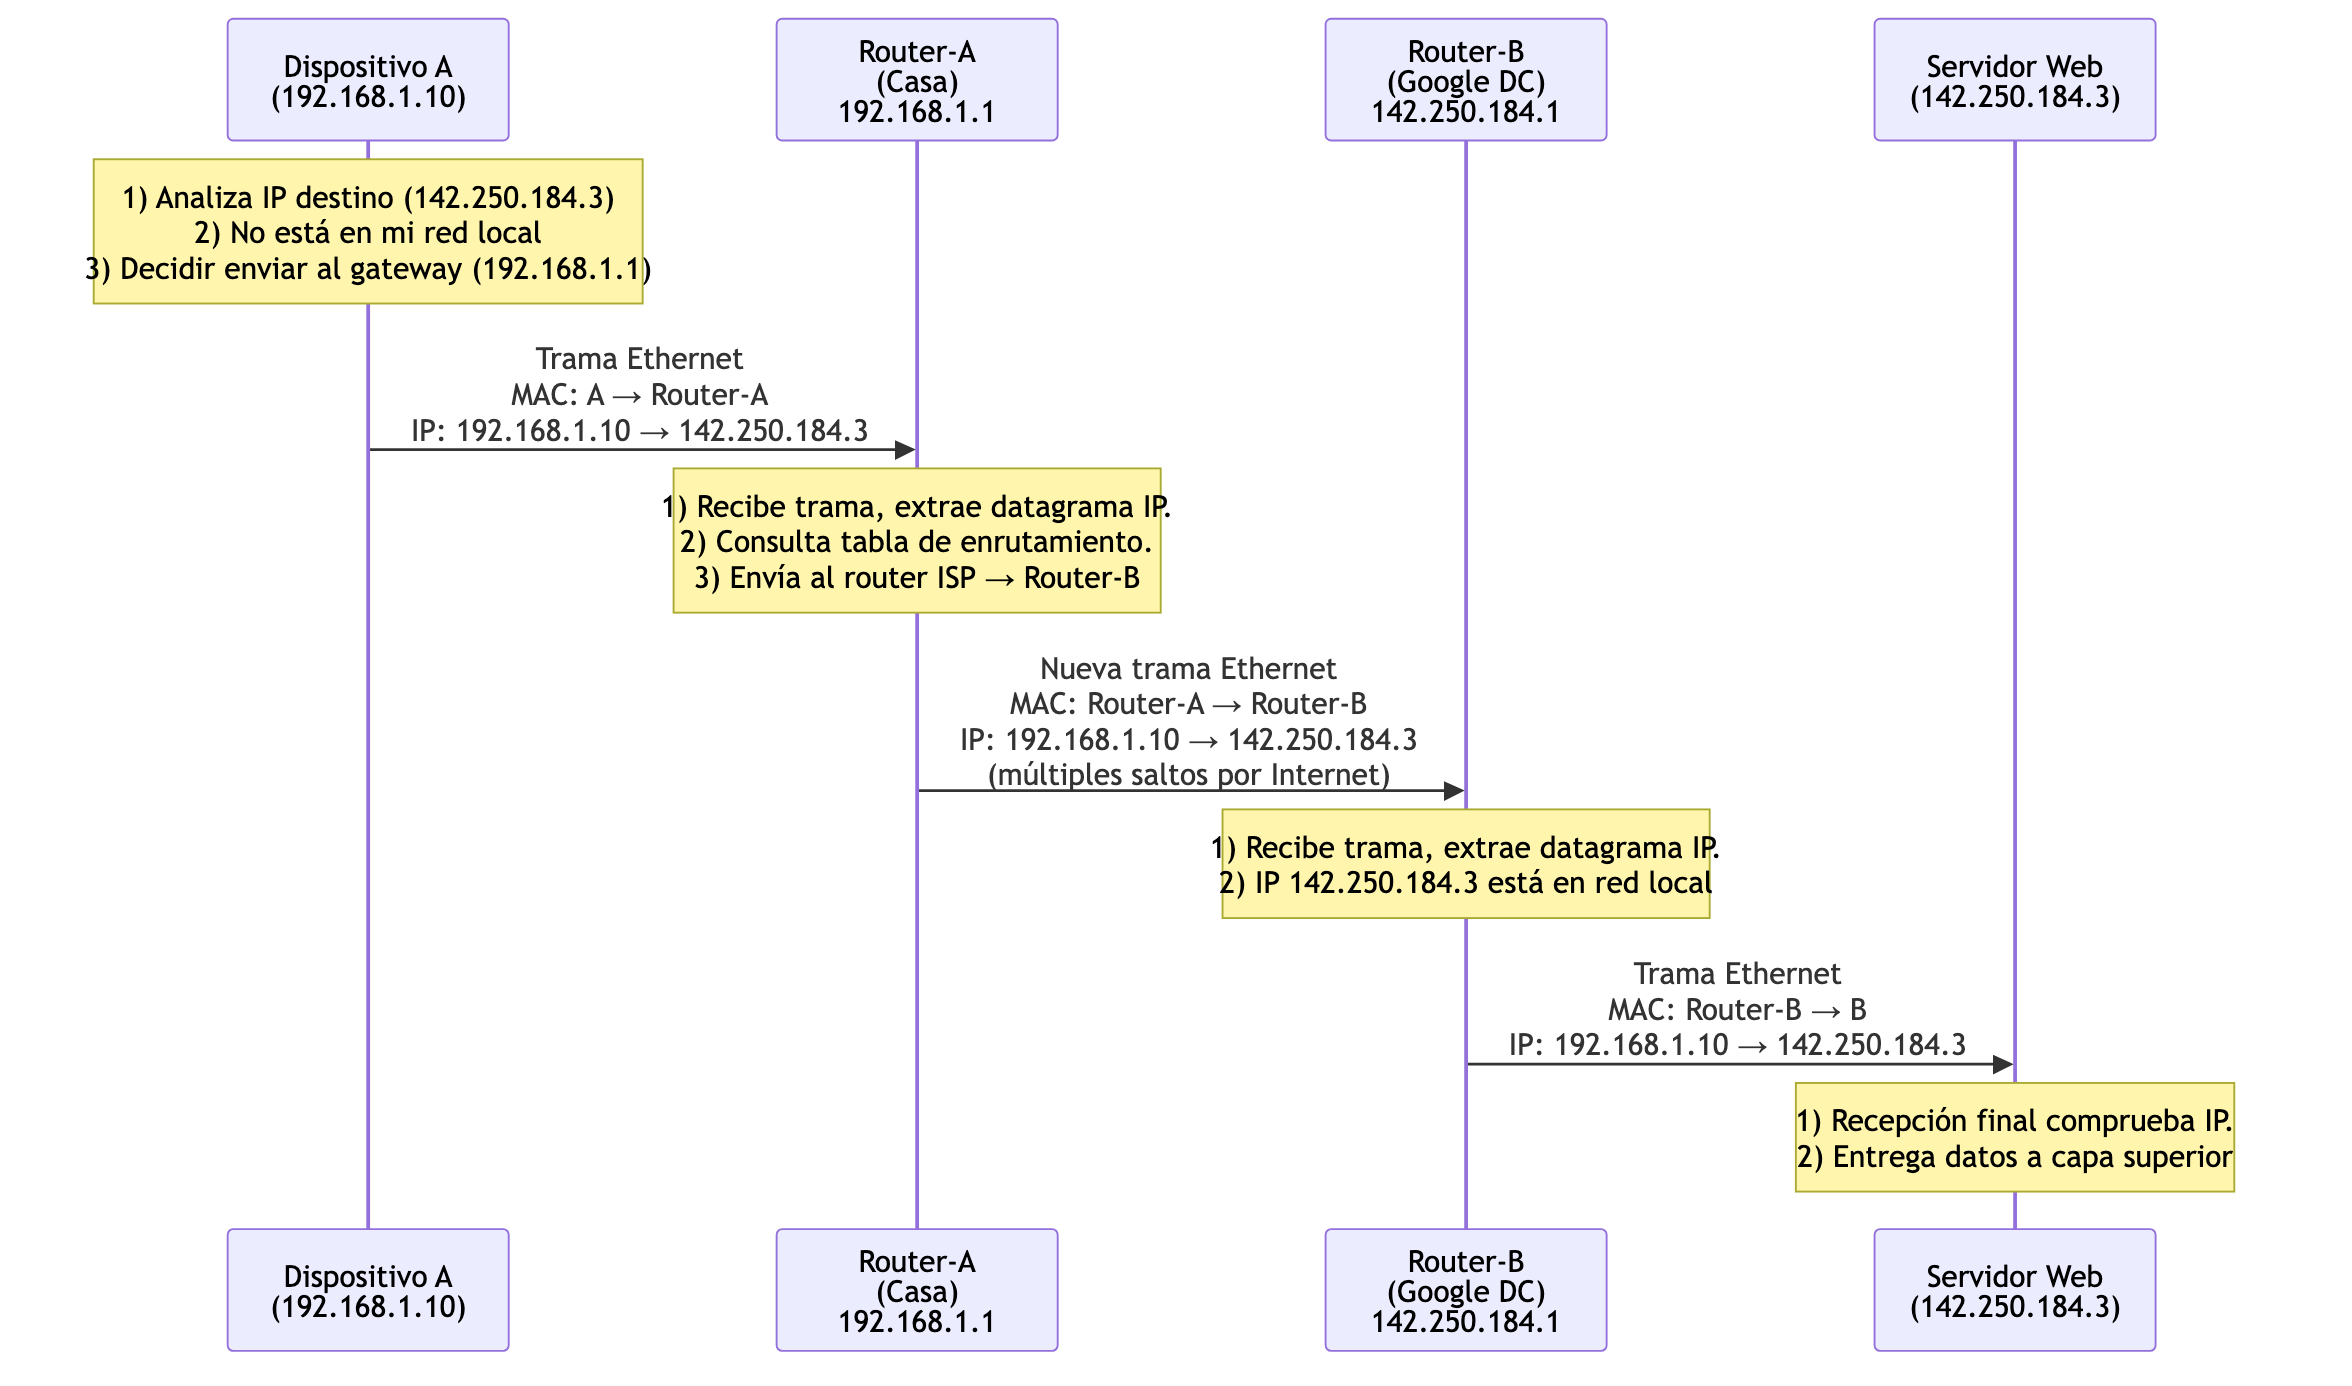
Aunque este ejemplo sea una simplificación, nos ayuda a introducir la funcionalidad de la capa de red, en concreto, de los routers y del protocolo IP. Generalmente, entre el Router-A y Router-B habría múltiples routers intermedios, pero el proceso seguiría siendo el mismo. En los siguientes apartados profundizaremos en las funcionalidades de la capa de red a través de los routers y el protocolo IP.
4.1 Funciones Fundamentales de la Capa de Red
La Capa de Red tiene dos funciones clave: el enrutamiento y el reenvío. El enrutamiento representa el proceso global mediante el cual la red determina las rutas óptimas que seguirán los paquetes de datos desde su origen hasta su destino final. Este proceso considera toda la topología de la red y puede tomar desde segundos hasta minutos para converger completamente. Los protocolos de enrutamiento más comunes son OSPF e IS-IS en redes internas y BGP entre dominios; RIP tiene interés histórico.
En contraste, el reenvío constituye un proceso local y extremadamente rápido que se encarga de mover los paquetes desde el puerto de entrada hasta el puerto de salida específico dentro del mismo router. Esta operación debe completarse en microsegundos para mantener el rendimiento de la red, por lo que se implementa directamente en hardware. El proceso se basa exclusivamente en la dirección IP de destino y utiliza únicamente la tabla de reenvío local del router para tomar decisiones inmediatas.
La interacción entre ambos procesos forma un sistema integrado donde los algoritmos de enrutamiento como RIP, OSPF y BGP generan la tabla de enrutamiento con rutas completas, la cual se traduce en una tabla de reenvío optimizada que contiene únicamente la información del siguiente salto (next-hop). Esta tabla de reenvío es la que finalmente permite tomar las decisiones de reenvío paquete por paquete de manera eficiente, creando un flujo continuo desde la planificación estratégica de rutas hasta la ejecución táctica del movimiento de datos.
Las responsabilidades de la capa de red varían según el tipo de dispositivo y su posición en el flujo de comunicación. En el host emisor, la capa de red recibe segmentos de TCP o UDP y los encapsula en datagramas IP añadiendo las cabeceras correspondientes. Durante este proceso, debe fragmentar los datagramas si exceden el MTU del enlace de salida y determinar si el destino es local (dentro de la misma red) o remoto para enviarlo. En el extremo opuesto, el host receptor debe reensamblar los fragmentos cuando sea necesario, verificar la integridad de los datos mediante el checksum de cabecera, extraer los segmentos y entregarlos a la capa de transporte apropiada, además de procesar las opciones de cabecera IP cuando estén presentes.
Los routers intermedios desempeñan un papel diferente pero crucial en este ecosistema. Su función principal consiste en examinar los campos de la cabecera IP, especialmente la dirección de destino, consultar sus tablas de enrutamiento para determinar el siguiente salto apropiado, y reenviar los paquetes por la interfaz de salida correspondiente.
4.2 Modelos de servicio
Existen dos paradigmas fundamentales para implementar servicios de capa de red, cada uno con filosofías y mecanismos completamente diferentes. La elección entre estos modelos determina aspectos cruciales como performance, confiabilidad, complejidad y escalabilidad de la red.
Las redes de circuitos virtuales (VC) emulan el comportamiento de los circuitos telefónicos tradicionales estableciendo “caminos virtuales” dedicados entre origen y destino. Su funcionamiento se desarrolla en tres fases claramente definidas: primero, el establecimiento de conexión mediante el envío de un mensaje SETUP desde el host origen, donde cada router intermedio reserva recursos como ancho de banda y buffers, crea una entrada en su tabla VC con un identificador único local, y reenvía la solicitud hasta que el host destino confirma con un mensaje ACK. Durante la fase de transferencia de datos, los paquetes solo necesitan llevar el VC ID asignado en lugar de la dirección de destino completa, permitiendo un reenvío rápido mediante consulta a la tabla VC, garantizando calidad de servicio (QoS) y manteniendo una ruta fija para todos los paquetes del flujo. Finalmente, la terminación se realiza mediante un mensaje TEARDOWN que libera los recursos previamente reservados y elimina las entradas de las tablas VC.
Esta arquitectura ofrece ventajas significativas como QoS predecible con garantías de rendimiento, overhead reducido en las cabeceras al usar solo el VC ID, control de flujo extremo a extremo y orden garantizado de los paquetes. Sin embargo, presenta desventajas importantes incluyendo la complejidad en el establecimiento y mantenimiento de conexiones, la necesidad de mantener estado por cada conexión en todos los routers, rigidez ante cambios en la topología de red y overhead adicional por la señalización requerida. Tecnologías como ATM, Frame Relay, X.25 y MPLS implementan este modelo de circuitos virtuales para aplicaciones que requieren garantías específicas de rendimiento.
Las redes de datagramas adoptan un enfoque completamente diferente al tratar cada paquete de manera independiente sin establecer conexiones previas entre origen y destino. Este modelo se caracteriza por la ausencia de estado de conexión en los routers, eliminando la necesidad de un proceso de setup inicial, y basa el reenvío en la dirección de destino completa contenida en cada paquete. Cada router procesa los paquetes independientemente. Como resultado, diferentes paquetes del mismo flujo puedan seguir rutas distintas a través de la red.
El modelo de datagramas presenta ventajas sustanciales en términos de simplicidad de diseño e implementación, robustez excepcional ante fallos de red ya que no depende de estados de conexión preestablecidos, flexibilidad para implementar balanceo dinámico de carga, escalabilidad superior al no requerir mantener estado por cada flujo, y adaptabilidad inmediata a cambios en la topología de red. Estas características hacen que las redes de datagramas sean especialmente adecuadas para entornos dinámicos y de gran escala como Internet.
No obstante, el modelo de datagramas también presenta limitaciones significativas que incluyen la ausencia de garantías de calidad de servicio (QoS), la posibilidad de que los paquetes lleguen fuera de orden al destino debido a las diferentes rutas que pueden tomar, el overhead adicional generado por incluir la dirección de destino completa en cada paquete, y la prestación únicamente de un servicio de mejor esfuerzo (best-effort) sin compromisos específicos de rendimiento. A pesar de estas limitaciones, el modelo de datagramas se ha convertido en el fundamento de Internet debido a su simplicidad, robustez y capacidad de adaptación a las condiciones cambiantes de la red.
Resumen comparativo:
| Aspecto | Circuitos Virtuales | Datagramas |
|---|---|---|
| Establecimiento | Requerido | No requerido |
| Estado en routers | Sí, por conexión | No |
| Direccionamiento | VC ID | Dirección IP completa |
| Enrutamiento | Ruta fija | Ruta por paquete |
| QoS | Garantías posibles | Best effort |
| Recuperación fallos | Difícil | Automática |
| Escalabilidad | Limitada | Alta |
| Overhead | Setup/teardown | Por paquete |
4.3 Dispositivos físicos de la Capa de Red
Los dispositivos de capa de red son los componentes hardware que hacen posible la interconexión de redes y la implementación de las funciones de enrutamiento y reenvío. Estos dispositivos varían considerablemente en complejidad, desde simples switches Layer 3 hasta routers core de alta capacidad.
Routers (Enrutadores)
Los routers constituyen la columna vertebral de Internet y las redes empresariales modernas. Su función principal es interconectar diferentes redes y determinar la ruta óptima para el reenvío de paquetes de datos. A diferencia de los switches que operan en la Capa de Acceso a la Red, los routers trabajan en la Capa de Red, tomando decisiones basadas en direcciones IP y manteniendo una visión global de la topología de red.
La arquitectura básica consta de cuatro componentes principales:
┌─────────────────┐    ┌─────────────────┐    ┌─────────────────┐
│                 │    │                 │    │                 │
│  Puertos de     │    │   Procesador    │    │  Puertos de     │
│   Entrada       │◄──►│      de         │◄──►│   Salida        │
│                 │    │  Enrutamiento   │    │                 │
└─────────────────┘    └─────────────────┘    └─────────────────┘
         ▲                        │                        ▲
         │              ┌─────────▼─────────┐              │
         │              │                   │              │
         └──────────────│ Fabric de         │──────────────┘
                        │ Conmutación       │
                        │                   │
                        └───────────────────┘
En los routers diferenciamos dos planos claramente separados:
plano de control: ejecuta el proceso de enrutamiento mediante software especializado y generan tablas de enrutamiento que contienen rutas completas hacia todos los destinos conocidos.
plano de datos: ejecuta el proceso de reenvío mediante hardware especializado para máxima eficiencia. Utiliza la tabla de enrutamiento generada en el plano de control.
Los puertos de entrada constituyen las puertas de recepción del router y realizan tres funciones críticas organizadas en secuencia. La terminación física proporciona la interfaz con medios de transmisión como cables de cobre o fibra óptica, convirtiendo las señales eléctricas u ópticas en datos digitales. El procesamiento de la capa de enlace maneja protocolos específicos como Ethernet, PPP o Frame Relay, extrayendo el datagrama IP de la trama correspondiente. La función de búsqueda IP consulta la tabla de reenvío usando el algoritmo de coincidencia de prefijo más largo para determinar hacia dónde dirigir cada paquete. Esta función debe ejecutarse a la velocidad del enlace para evitar crear cuellos de botella en el sistema.
Los puertos de salida gestionan el tráfico que abandona el router mediante un proceso inverso al de entrada. La bufferización y scheduling implementa sistemas de colas sofisticados que aplican políticas de calidad de servicio, decidiendo qué paquetes enviar primero según sus prioridades. El procesamiento de la capa de enlace encapsula el datagrama IP en la trama apropiada para el protocolo del enlace de salida. Finalmente, la terminación física convierte los datos digitales en señales eléctricas u ópticas para su transmisión.
El procesador de enrutamiento funciona como el cerebro del sistema, ejecutando los protocolos de enrutamiento que intercambian información con otros routers para mantener actualizado el conocimiento de la topología de red. También gestiona funciones administrativas como SNMP para monitoreo remoto, procesamiento ICMP para herramientas de diagnóstico como ping y traceroute, y la computación de las tablas de reenvío optimizadas a partir de las tablas de enrutamiento.
Por último, NAT es una función que involucra ambos planos (lo veremos después). Al principio operaba sólo en el plano de control, tomando un tiempo significativo. En la actualidad, las sesiones se gestionan en el plano de control y la traducción por paquete en hardware especializado en el plano de datos.
Proceso de Reenvío de Paquetes
El proceso de reenvío sigue una secuencia precisa y optimizada que se ejecuta para cada paquete:
Recepción y procesamiento inicial: El paquete llega al puerto de entrada desde el enlace físico, se procesa la cabecera de la capa de enlace correspondiente y se extrae el datagrama IP.
Verificación de integridad: Se verifica el checksum de la cabecera IP para detectar posibles errores de transmisión y se comprueba que el valor TTL sea mayor que cero.
Extracción de información de destino: Se extrae la dirección IP de destino de la cabecera del datagrama para utilizarla en la decisión de reenvío.
Consulta de tabla de reenvío: Se aplica el algoritmo de coincidencia de prefijo más largo en la tabla de reenvío para determinar la interfaz de salida apropiada y obtener la dirección del siguiente salto.
Modificación del paquete: Se decrementa el campo TTL en una unidad y se recalcula el checksum de la cabecera IP para mantener la integridad de los datos. Si el TTL llega a cero después del decremento, el router descarta el paquete y envía un mensaje ICMP “Time Exceeded” al host origen, evitando así loops infinitos en la red.
Resolución de direcciones: Si es necesario, se resuelve la dirección MAC del dispositivo del siguiente salto mediante el protocolo ARP.
Encapsulación y envío: Se encapsula el datagrama IP en una nueva trama según el protocolo de la capa de enlace del puerto de salida y se transmite por la interfaz física correspondiente.
Switches de Capa 3
A medida que las redes locales crecieron en complejidad, surgió la necesidad de dispositivos que combinaran la velocidad del switching con las capacidades del routing. Los switches Layer 3 llenan este nicho específico. La principal diferencia es la implementación a nivel de hardware del procesamiento, haciéndolo mucho más rápido. A modo de comparativa tenéis la siguiente tabla:
| Aspecto | Router Tradicional | Switch L3 |
|---|---|---|
| Reenvío | Software/ASIC | Hardware puro |
| Latencia | Microsegundos | Nanosegundos |
| Throughput | Limitado por CPU | Wire-speed |
| Costo | Mayor | Menor |
| Flexibilidad | Alta | Limitada |
4.4 Protocolos
Protocolo IP
IP es el protocolo principal de la capa de red en la arquitectura TCP/IP. Define la estructura de datagramas, direccionamiento y mecanismos básicos de entrega. Las características principales de IP son:
- Sin conexión: No requiere establecimiento previo.
- No confiable: No garantiza entrega, orden, o integridad.
- Best effort: Hace el “mejor esfuerzo” por entregar paquetes.
- Independiente del medio: Funciona sobre cualquier tecnología de enlace.
Dentro de IP hay dos versiones. IPv4 diseñado en los años 70 y IPv6, como evolución de IPv4 enfocado a solventar las limitaciones de IPv4, en especial el número de IPs disponibles. Empezaremos por IPv4.
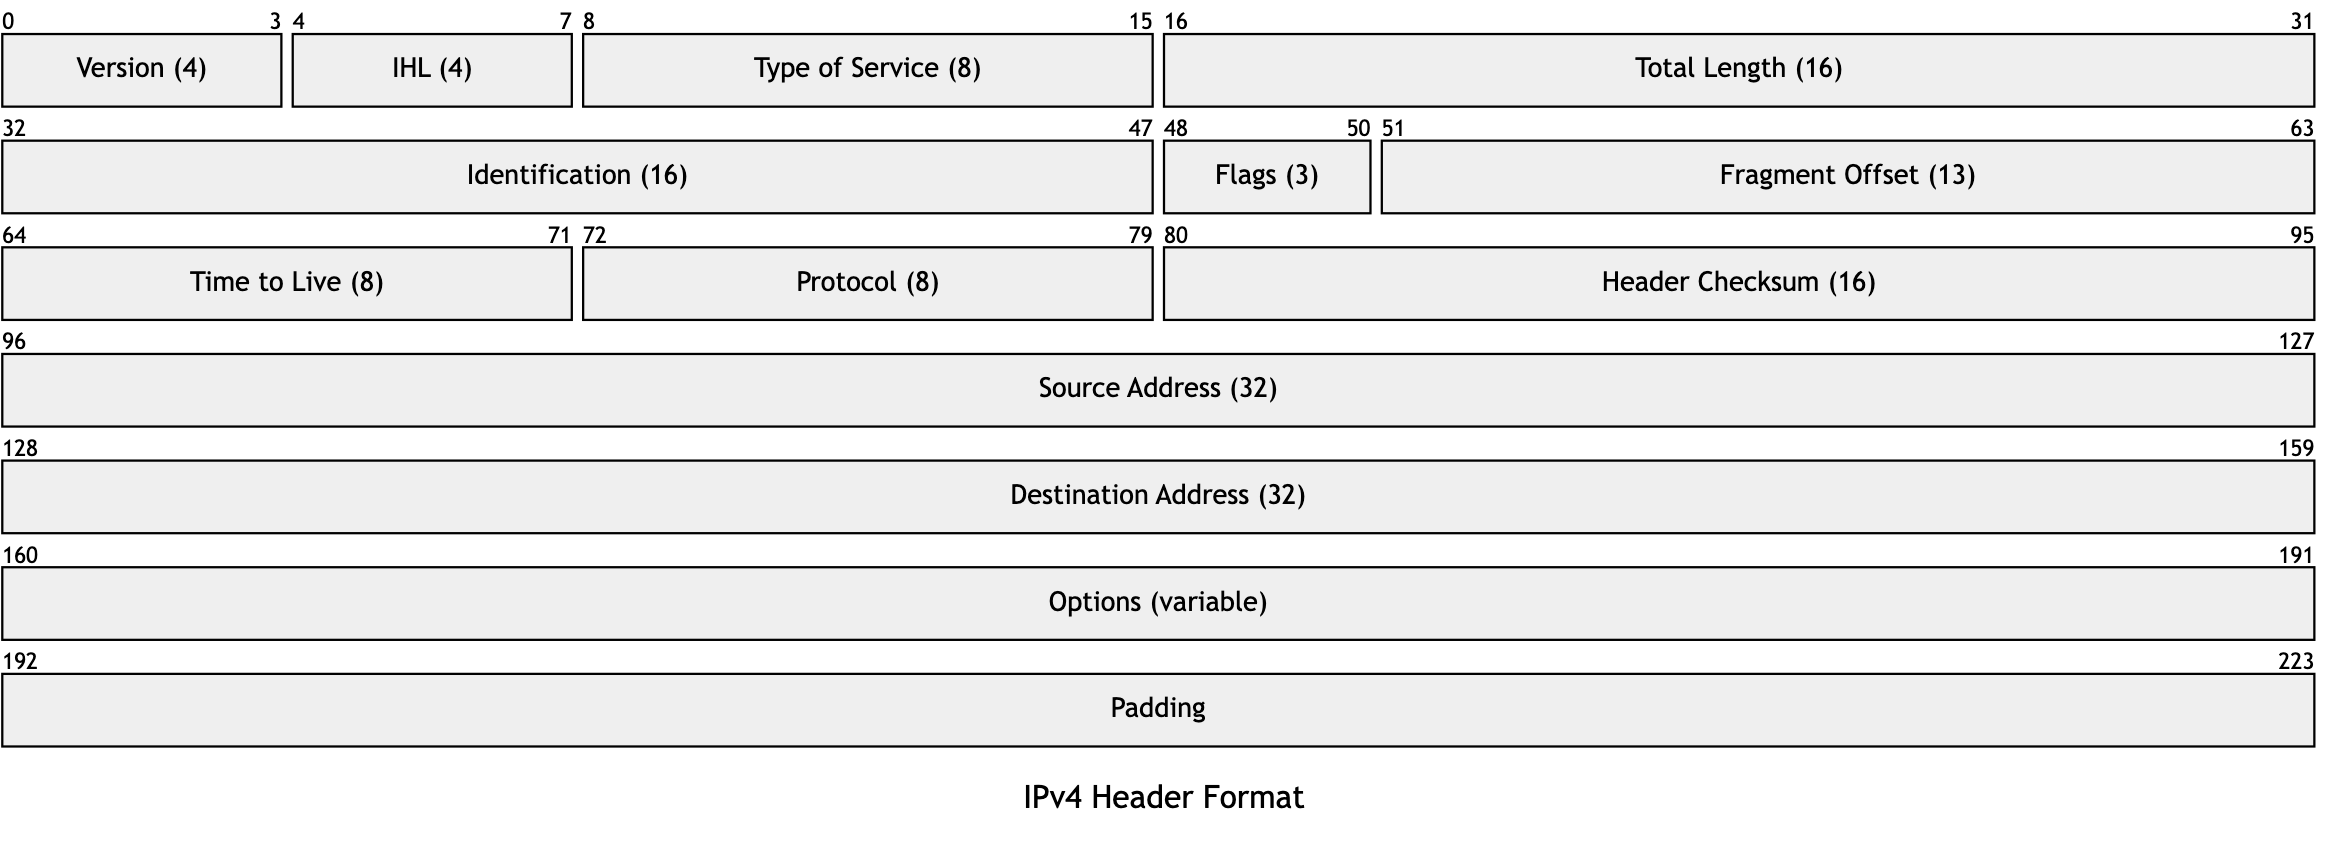
El datagrama IPv4 es la unidad básica de información que viaja por Internet (Ver estructura en Figura 4.3). Utiliza una cabecera de longitud variable (mínimo 20 bytes) que contiene la información esencial para el enrutamiento y entrega de paquetes a través de Internet. Los campos más críticos incluyen las direcciones IP de origen y destino que determinan los puntos de comunicación, el campo TTL que previene loops infinitos al decrementarse en cada router, el campo Protocol que identifica el protocolo de capa superior (TCP, UDP, ICMP), y los campos de fragmentación (Identification, Flags, Fragment Offset) que permiten dividir y reensamblar datagramas que exceden el MTU del enlace. El checksum protege únicamente la cabecera, delegando la protección de los datos a las capas superiores, mientras que el campo Total Length especifica el tamaño completo del datagrama para su procesamiento correcto.
Las direcciones IPv4 (IPs) son identificadores únicos de un dispositivo dentro de una red. En IPv4 tienen un formato de 32 bits que se organiza en 4 octetos separados por puntos. Por ejemplo, 192.168.1.1 o 10.0.1.50. Debido a la longitud de 32 bits, el número de direcciones IP posibles son \(2^{32}\), aproximadamente 4.3 miles de millones. Estas direcciones se organizan en dos partes, la parte de red y la parte de host, además tenemos la máscara de red que nos ayuda a distinguir ambas partes. Por ejemplo, 192.168.1.1 con máscara de red 255.255.255.0 o 10.0.1.50 con máscara de red 255.255.0.0, siendo la parte azul la parte de red y la roja la parte del host. Para obtener la dirección de red utilizamos el operador binario AND: 192.168.1.1 & 255.255.255.0 = 192.168.1.0. En CIDR, que veremos más adelante, esta máscara 255.255.255.0 se representa como /24.
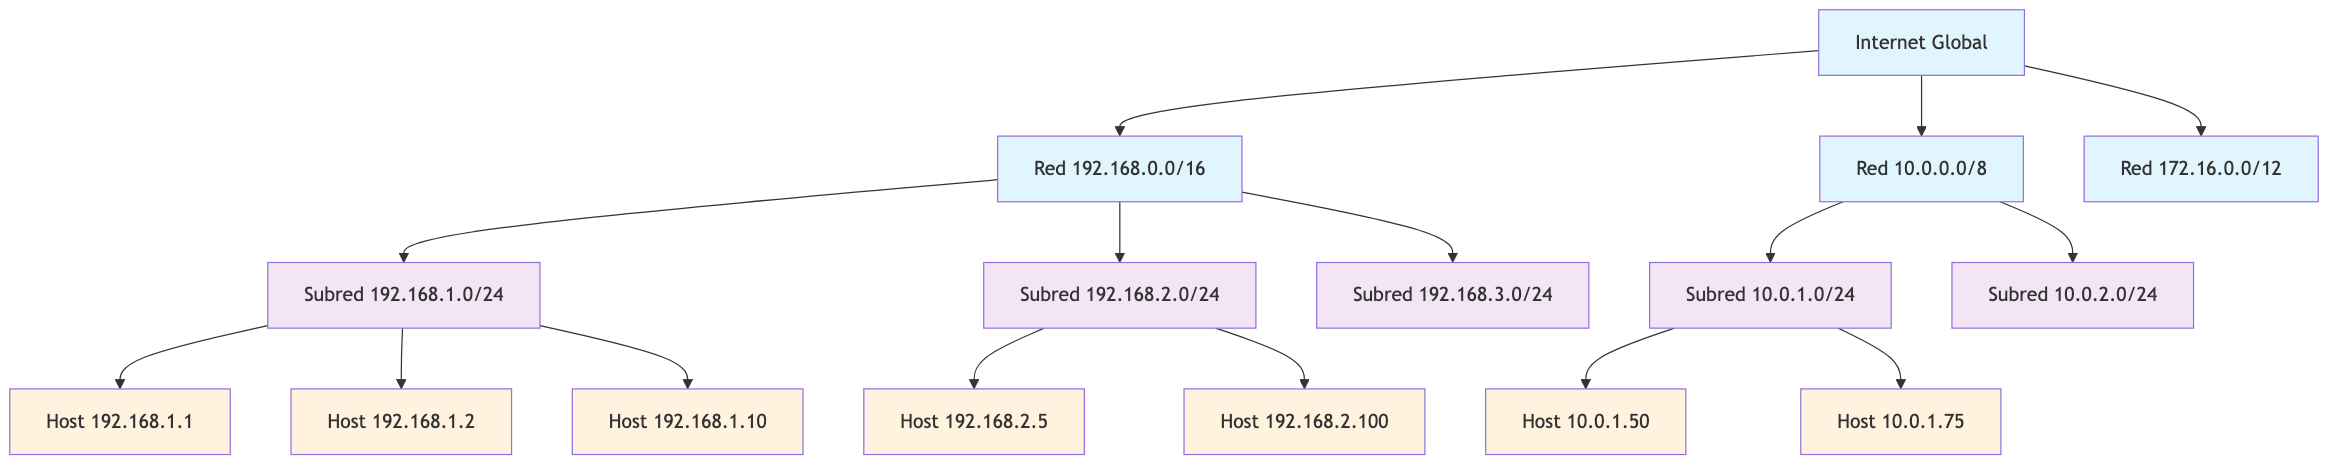
Esta división entre parte de red y parte de host permite representar jerárquicamente la estructura de direccionamiento, como se muestra en la Figura 4.4. Los routers pueden tomar decisiones de reenvío basándose únicamente en la parte de red de la dirección destino, consultando sus tablas locales para determinar la interfaz de salida. Gracias a esta organización, es posible la agregación de rutas, donde varias redes pequeñas se resumen en una sola entrada de mayor alcance. Por ejemplo, dos subredes /28 contiguas (192.168.1.0/28 y 192.168.1.16/28) pueden representarse como un único bloque /27 (192.168.1.0/27), reduciendo de dos entradas a una. Este mecanismo permite que los routers mantengan información consolidada sobre redes remotas sin necesidad de conocer cada host o subred en detalle, lo que disminuye drásticamente el tamaño de las tablas de reenvío y hace escalable la infraestructura global de Internet.
La estructura de direccionamiento IPv4, que permite distinguir entre red y host para generar una arquitectura jerárquica de redes, inicialmente utilizaba un sistema de clases. En este sistema de clases, las direcciones IPv4 se categorizaban en tres grupos principales según los bits iniciales del primer octeto, determinando la división entre bits de red y host. La Clase A comenzaba con bit 0, la Clase B con bits “10”, y la Clase C con bits “110”, creando saltos enormes entre las capacidades de cada categoría que generaban ineficiencias significativas en la asignación.
| Clase | Rango de Direcciones | Primer Bit(s) | Bits de Red | Bits de Host | Redes Disponibles | Hosts por Red | Uso Típico |
|---|---|---|---|---|---|---|---|
| A | 0.0.0.0 - 127.255.255.255 | 0 | 7 | 24 | 1261 | 16,777,214 | ISPs, gobiernos, organizaciones masivas |
| B | 128.0.0.0 - 191.255.255.255 | 10 | 14 | 16 | 16,384 | 65,534 | Universidades, empresas medianas |
| C | 192.0.0.0 - 223.255.255.255 | 110 | 21 | 8 | 2,097,152 | 254 | Empresas pequeñas, oficinas locales |
Sin embargo, la rigidez del sistema de clases generaba problemas críticos. Una organización con 1,000 hosts enfrentaba un dilema: elegir una red Clase B desperdiciando 64,534 direcciones (99.5% de ineficiencia) o gestionar múltiples redes Clase C con mayor complejidad administrativa. Esta inflexibilidad aceleró el agotamiento del espacio IPv4 y motivó el desarrollo de alternativas más eficientes.
Para solventar este problema se introdujo CIDR. La innovación fundamental consistió en la notación /x que indica exactamente cuántos bits destinan a la parte de red. Por ejemplo, 192.168.1.0/24 significa que los primeros 24 bits identifican la red, dejando 8 bits para hosts (254 hosts utilizables). CIDR permite asignar direcciones en bloques de cualquier tamaño potencia de 2, eliminando el desperdicio masivo del sistema anterior. Una organización que necesite 500 hosts puede recibir un /23 (510 hosts) en lugar de desperdiciar una Clase B completa. Esta flexibilidad mejoró drásticamente la eficiencia de asignación del espacio IPv4 y la simplificación de las tablas de enrutamiento globales mediante la agregación de rutas.
Para funcionar, CIDR requiere el algoritmo de longest prefix matching para búsquedas en tablas de enrutamiento. Cuando un router recibe un paquete, evalúa todas las rutas que coinciden con la dirección destino y selecciona aquella con el prefijo más específico. En una tabla con rutas 192.168.0.0/16, 192.168.1.0/24 y 192.168.1.128/25, el destino 192.168.1.100 coincide con las dos primeras pero selecciona 192.168.1.0/24 por tener el prefijo más largo (24 bits vs 16 bits). Este mecanismo garantiza que el tráfico tome siempre la ruta más específica disponible.
Independientemente del sistema de direccionamiento utilizado (clases o CIDR), IPv4 mantiene direcciones especiales con propósitos específicos:
- 0.0.0.0/32: This host on this network. Referencia un host sin IP configurada. Se utiliza en el proceso de configuración (DHCP).
- 127.0.0.0/8: Loopback. Los paquetes no salen del host local y se utiliza para servicios y pruebas. Un ejemplo común es localhost, con IP 127.0.0.1.
- 255.255.255.255/32: Limited broadcast. Broadcast a todos los hosts en red local. No atraviesa routers.
- x.x.x.0: Dirección de red. Todos los bits del host a 0 (con la máscara de red). Identifica a la red misma.
- x.x.x.255: Directed broadcast. Todos los bits de host a 1. Broadcast dirigido a una red específica.
En el sistema de clases, las direcciones de red y broadcast seguían patrones fijos según la clase, pero con CIDR se adaptan dinámicamente a la máscara de subred específica utilizada.
Ambos sistemas establecen una serie de rangos, denominados privados, que son exclusivos para redes internas. Estas direcciones no son enrutables en Internet público, ya que los routers globales están configurados para descartarlas, evitando conflictos de direccionamiento. La principal ventaja radica en que múltiples organizaciones pueden reutilizar los mismos rangos internamente sin interferir entre sí, conservando el escaso espacio IPv4 público. Para acceder a Internet, estas redes requieren NAT, que traduce direcciones privadas a públicas. Los rangos delimitados son: 10.0.0.0/8 (16.7 millones de hosts, para grandes organizaciones), 172.16.0.0/12 (1 millón de hosts, para empresas medianas) y 192.168.0.0/16 (65,000 hosts, para hogares y oficinas pequeñas).
Por último, en el protocolo IP hay una tamaño máximo para el datagrama. Este tamaño se conoce como MTU (del inglés, Maximum Transmission Unit), y puede variar dependiendo de la tecnología subyacente, por ejemplo, en Ethernet es 1500 bytes y en Token Ring es 4464 bytes. Cuando el tamaño del datagrama es superior al MTU, el datagrama se fragmenta en trozos más pequeños y se reensamblará posteriormente en el destino. Una consideración importante es que el protocolo IP sí mantiene el orden de la información del datagrama. Es decir, si yo envío un datagrama que se tiene que fragmentar, IP reensambla los fragmentos en orden en el destino. Cuando decimos que no garantiza el orden es que si primero envío el datagrama A y después otro datagrama B (independientes), puede que la aplicación reciba primero el datagrama B y después el A, y no tendré forma de saber si uno va antes que el otro.
IPv6
IPv6 surge como respuesta a las limitaciones críticas de IPv4, principalmente el agotamiento de su espacio de direcciones de 32 bits que solo proporciona \(4.3 \times 10^{9}\) direcciones únicas. Además, IPv4 presenta problemas de fragmentación ineficiente que requiere procesamiento en routers intermedios, configuración manual compleja sin capacidades de autoconfiguración, implementación de seguridad como complemento opcional (IPSec), y limitaciones en calidad de servicio con campos TOS poco efectivos. Estos desafíos hacen insostenible IPv4 para el crecimiento exponencial de dispositivos conectados a Internet.
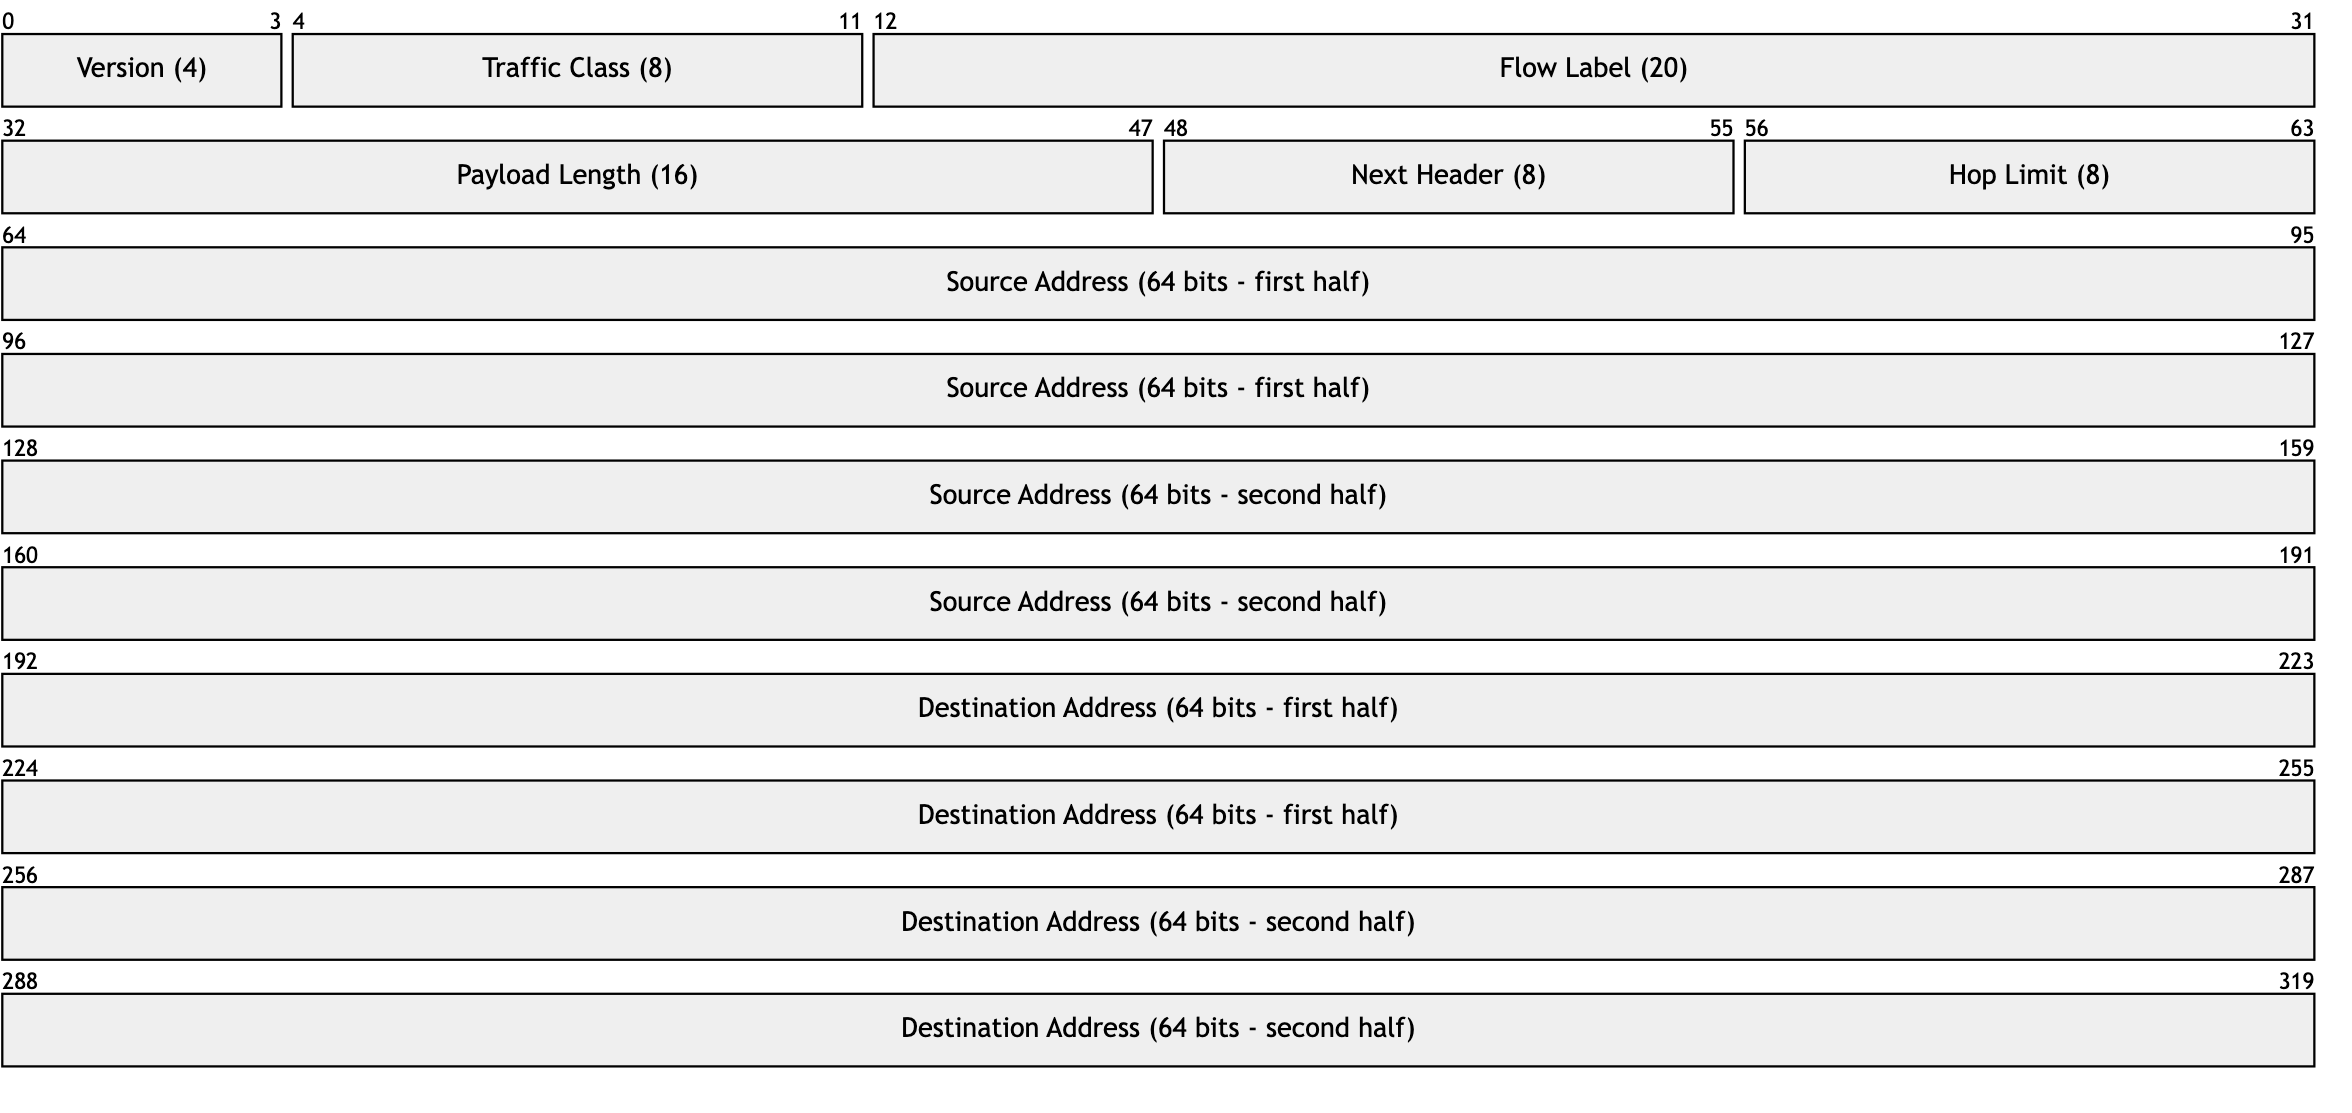
IPv6 revoluciona el protocolo con un espacio de direcciones masivo de 128 bits que proporciona \(2^{128} = 3.4 \times 10^{38}\) direcciones, utilizando notación hexadecimal con reglas de compresión para simplificar su representación. La cabecera, ver Figura 4.5, se simplifica a un formato fijo de 40 bytes eliminando el checksum para reducir el procesamiento en routers, e integra características avanzadas como autoconfiguración SLAAC, seguridad IPSec integrada en el diseño (soporte recomendado, no obligatorio), y mejor calidad de servicio mediante campos Traffic Class y Flow Label. Debido a la cantidad de dispositivos en la red, la migración de IPv4 a IPv6 se realiza de forma gradual mediante estrategias que permiten la interoperabilidad entre ambos protocolos.
Protocolo ICMP (Internet Control Message Protocol)
ICMP es un protocolo complementario a IP que proporciona mecanismos de control, diagnóstico y reporte de errores en redes. Utiliza IP para su transporte (protocolo número 1) pero opera como herramienta de gestión de red. Es no orientado a conexión, no garantiza entrega, y está implementado obligatoriamente en todos los dispositivos IP. Su formato básico incluye campos Type, Code, Checksum y datos adicionales según el tipo de mensaje.
Los mensajes ICMP se clasifican en dos categorías principales: mensajes de error y mensajes de consulta. Los mensajes de error incluyen “Destination Unreachable” (Type 3) que indica problemas de alcance como red, host o puerto inaccesible; “Time Exceeded” (Type 11) usado cuando el TTL expira en tránsito; “Parameter Problem” (Type 12) para errores de configuración; o “Packet Too Big” en el mecanismo de MTU Discovery de IPv6. Los mensajes de consulta incluyen “Echo Request/Reply” (Type 8/0) utilizados por ping para verificar conectividad y medir latencia, y “Timestamp Request/Reply” (Type 13/14) para sincronización temporal.
Ping - Verificación de conectividad:
$ ping 8.8.8.8
PING 8.8.8.8 (8.8.8.8): 56 data bytes
64 bytes from 8.8.8.8: icmp_seq=0 ttl=55 time=15.1 ms
64 bytes from 8.8.8.8: icmp_seq=1 ttl=55 time=14.9 ms
Este ejemplo muestra ping enviando Echo Request (Type 8) al servidor DNS de Google y recibiendo Echo Reply (Type 0) exitosamente. Las respuestas muestran latencias de ~15ms, TTL=55, y confirman conectividad funcional.
Traceroute - Descubrimiento de ruta:
$ traceroute google.com
 1  192.168.1.1 (192.168.1.1)  3.414 ms  3.863 ms  1.752 ms
 2  100.70.0.1 (100.70.0.1)  5.245 ms  4.996 ms  4.405 ms
 3  10.14.0.53 (10.14.0.53)  7.091 ms  4.812 ms  4.892 ms
 4  10.14.246.6 (10.14.246.6)  4.209 ms  4.406 ms  4.230 ms
 5  * * *
 6  72.14.195.182 (72.14.195.182)  4.665 ms
    72.14.194.132 (72.14.194.132)  3.950 ms
    72.14.195.182 (72.14.195.182)  4.968 ms
 7  74.125.245.171 (74.125.245.171)  5.109 ms  5.751 ms  5.791 ms
 8  142.251.49.55 (142.251.49.55)  4.185 ms
    142.251.49.53 (142.251.49.53)  5.317 ms
    142.251.49.55 (142.251.49.55)  3.791 ms
 9  mad41s11-in-f14.1e100.net (142.250.185.14)  4.722 ms  6.253 ms  4.893 ms
Este ejemplo revela la ruta completa hacia google.com incrementando TTL progresivamente. Cada router responde “Time Exceeded” (Type 11, Code 0) mostrando su IP. El salto 5 muestra timeouts (*), el salto 6 y 8 muestra balanceadores de carga, y finalmente alcanza el servidor de Google en el salto 9.
NAT (Network Address Translation)
NAT surgió como una solución al problema del agotamiento de direcciones IPv4, permitiendo que múltiples dispositivos en una red privada compartan una sola dirección IP pública. Esta técnica se basa en el uso de direcciones privadas que pueden reutilizarse sin conflictos. El dispositivo NAT, típicamente integrado en routers de acceso doméstico o empresarial, actúa como intermediario entre la red interna y externa, traduciendo direcciones y puertos en tiempo real.
El funcionamiento de NAT se basa en mantener una tabla de traducción que mapea combinaciones de dirección IP privada y puerto interno con la dirección IP pública y un puerto externo único. Cuando un dispositivo interno inicia una conexión hacia Internet, el router NAT reemplaza la dirección IP de origen privada y el puerto por su dirección IP pública y un puerto disponible de su pool, registrando esta asociación en su tabla. Cuando llega la respuesta desde Internet, el router consulta su tabla de traducción para determinar a qué dispositivo interno debe entregar el paquete, revirtiendo la traducción antes de reenviarlo a la red local.
En la Figura 4.6 podemos ver dos ejemplos de NAT. El Host A envía un paquete desde 192.168.1.10:12345 hacia 8.8.8.8:80. El router NAT lo intercepta, reemplaza el origen por 203.0.113.100:5001 y crea una entrada en su tabla: 192.168.1.10:12345 ↔︎ 5001. Cuando el servidor responde a 203.0.113.100:5001, el router consulta su tabla NAT, encuentra la correspondencia y reenvía el paquete a 192.168.1.10:12345. El proceso en el Host B sería idéntico, y gracias a NAT habríamos podido comunicarnos con dos dispositivos a través de una única IP.
Red Interna (192.168.1.0/24)          NAT Router          Internet
                                    (203.0.113.100)

┌─────────────┐                    ┌─────────────┐     ┌─────────────┐
│Host A       │ ────────────────── │             │ ─── │Servidor Web │
│192.168.1.10 │ Src: 192.168.1.10  │             │     │8.8.8.8:80   │
│Port: 12345  │ Dst: 8.8.8.8:80    │   Tabla     │     └─────────────┘
└─────────────┘                    │     NAT     │            ▲
                                   │             │            │
┌─────────────┐                    │192.168.1.10:│ Src: 203.0.113.100
│Host B       │ ────────────────── │12345 → 5001 │ Dst: 8.8.8.8:80
│192.168.1.20 │ Src: 192.168.1.20  │             │            │
│Port: 54321  │ Dst: 8.8.8.8:80    │192.168.1.20:│            │
└─────────────┘                    │54321 → 5002 │◄───────────┘
                                   └─────────────┘

                Traducción Salida              Traducción Entrada
    192.168.1.10:12345 → 203.0.113.100:5001    203.0.113.100:5001 → 192.168.1.10:12345
192.168.1.20:54321 → 203.0.113.100:5002 203.0.113.100:5002 → 192.168.1.20:54321Sin embargo, NAT presenta limitaciones significativas como la imposibilidad de establecer conexiones entrantes sin configuración manual de port forwarding, complicaciones con aplicaciones que embeben direcciones IP en sus datos (como algunos protocolos VoIP), y la pérdida del principio end-to-end de Internet. A pesar de estas limitaciones, NAT se ha convertido en ubicuo en redes domésticas y empresariales, siendo una pieza fundamental que ha permitido que Internet continúe funcionando mientras se desarrolla la transición hacia IPv6.
La limitación de conexiones entrantes impide que otros dispositivos sean capaces de conectarse a nosotros directamente. Esto impide, por ejemplo, que dos personas puedan conectarse entre sí desde sus casas. Por otra parte, también hace más seguro estar conectado a la red. En determinados casos, conectarse entre sí puede mejorar la experiencia, mejorar la privacidad, o reducir la necesidad de servidores intermedios y sus consecuentes recursos. Para ello, se pueden utilizar diferentes técnicas que permiten saltarse las limitaciones del NAT:
- Hole punching: Técnica donde ambos dispositivos intentan conectarse simultáneamente al otro a través de sus respectivos NATs. El NAT crea temporalmente “agujeros” en su tabla de traducción cuando detecta tráfico saliente, permitiendo que la respuesta del otro extremo pase. Funciona peor (es más difícil) con NAT simétrico y requiere coordinación temporal precisa.
- STUN (Session Traversal Utilities for NAT): Protocolo que permite a un dispositivo descubrir su dirección IP pública y el tipo de NAT que tiene. Un servidor STUN externo ayuda al cliente a determinar cómo el NAT modifica sus paquetes, información crucial para establecer conexiones directas. Es especialmente útil para aplicaciones de tiempo real como VoIP.
- TURN (Traversal Using Relays around NAT): Cuando el hole punching falla, TURN proporciona un servidor relay que actúa como intermediario. Aunque no elimina completamente la necesidad de servidores, centraliza el tráfico en un punto controlado. Es más confiable pero consume más ancho de banda y recursos del servidor.
- UPnP (Universal Plug and Play): Permite que las aplicaciones configuren automáticamente el router para abrir puertos específicos. El dispositivo solicita al router que cree reglas de port forwarding temporales o permanentes. Es conveniente pero requiere que el router soporte UPnP y puede presentar riesgos de seguridad si no se gestiona adecuadamente.
Las direcciones 0.0.0.0/8 y 127.0.0.0/8 están reservadas para funciones especiales.↩︎