6 Capa de aplicación
La capa de aplicación define los protocolos que utilizarán las aplicaciones para intercambiar datos. Las aplicaciones generalmente se representan con procesos, y por lo tanto, la capa de aplicación se centra en la comunicación entre procesos. Este nivel de ejecución nos va a quedar más claro si tenemos en cuenta que podemos crear nuestros propios protocolos que se ejecuten a nivel de capa de aplicación.
A continuación veremos un ejemplo de protocolo definido en la capa de aplicación, que realiza una función de “echo”, es decir, repite la información que recibe. Además, este pequeño ejemplo nos servirá para introducir los tipos de arquitecturas que pueden tener una aplicación de red. En concreto, este ejemplo utilizará una arquitectura cliente - servidor. En este tipo de arquitectura, tenemos un host (servidor) que está siempre activo con una dirección IP conocida y que ofrece servicio a otros hosts (clientes). Estos clientes podrán estar activos o no, y no se comunican entre ellos, sólo con el servidor. En este ejemplo tendremos un servidor, cuya funcionalidad será devolver la información recibida, con el formato “Echo: {message}”, donde {message} es el contenido recibido. El servidor continuará contestando la petición de los clientes hasta que reciba el mensaje “quit”, mediante el cual se cerrará la conexión entre ambos.
A continuación se muestra el servidor. Está programado en JavaScript, que veremos en la siguiente parte del libro. No os preocupéis si no entendéis todo, es simplemente a modo de ilustración.
const net = require('net');

function echoServer() {
    const server = net.createServer();

    server.on('connection', (socket) => {
        const clientAddress = `${socket.remoteAddress}:${socket.remotePort}`;
        console.log(`Client connected: ${clientAddress}`);

        handleClient(socket, clientAddress);
    });

    server.listen(8888, () => {
        console.log('Echo server listening on localhost:8888');
    });
}

function handleClient(socket, clientAddress) {
    socket.on('data', (data) => {
        const message = data.toString('utf-8').trim();
        console.log(`[${clientAddress}] ${message}`);

        if (message.toLowerCase() === 'quit') {
            socket.end();
            return;
        }

        // Echo back
        const echoResponse = `Echo: ${message}`;
        socket.write(echoResponse);
    });

    socket.on('close', () => {
        console.log(`[${clientAddress}] Disconnected`);
    });

    socket.on('error', (err) => {
        console.log(`[${clientAddress}] Error: ${err.message}`);
    });
}
Este servidor está formado por dos funciones, la función “handleClient” y la función “echoServer”. Empezando por “echoServer”, en las primeras líneas se crea un servidor TCP usando el módulo ‘net’ de Node.js. El servidor utiliza el modelo basado en eventos de JavaScript - cuando se conecta un cliente, se dispara automáticamente el evento ‘connection’, que delega el procesamiento del cliente a “handleClient”. La función “handleClient” define el “protocolo” mediante eventos: escucha el evento ‘data’ de forma indefinida hasta que se reciba un mensaje con la palabra “quit”, procesa los datos recibidos y los devuelve al cliente con el formato “Echo: {message}”. Esta ejecución también puede terminar cuando se disparan los eventos ‘close’ (cliente desconecta) o ‘error’ (error en la conexión), que son manejados automáticamente por el sistema de eventos de Node.js. Si os fijáis en esta función trabajamos con la variable “socket”, que es la interfaz entre la capa de aplicación y la capa de transporte. Dicho de otra forma, es la interfaz que tenemos de interactuar con la capa inferior, y la capa inferior con nosotros. El servidor queda escuchando en localhost:8888 y puede manejar múltiples clientes simultáneamente gracias al bucle de eventos asíncrono de Node.js.
Ahora pasaremos a la parte del cliente:
import socket

def echo_client():
    """Interactive echo client"""

    client_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    client_socket.connect(('localhost', 8888))

    while True:
        message = input("Enter message: ")

        if message.lower() == 'quit':
            client_socket.send(message.encode('utf-8'))
            break

        client_socket.send(message.encode('utf-8'))
        response = client_socket.recv(1024).decode('utf-8')
        print(f"Server response: {response}")

    client_socket.close()
En este caso el código está hecho con Python, no es un requisito necesario y podría estar en JavaScript, pero quería remarcar que la definición de protocolos en red permite la comunicación entre dos procesos que están en la misma u otra máquina, independientemente de su lenguaje de programación 1. En este cliente de Python tenemos una única función que representa al cliente, “echo_client”, donde en las primeras líneas establecemos una conexión con el servidor de JavaScript. Fijaos en el ('localhost', 8888), con esta combinación de identificador de máquina, “localhost”, podemos identificar el host donde está el servidor, y con el puerto, 8888, podemos identificar el proceso que corresponde al servidor. Como en el anterior ejemplo, tenemos un “socket” que permite una interacción bidireccional con la capa de transporte. No os preocupéis por estos detalles, los veremos en el siguiente apartado.
Con este ejemplo hemos ilustrado los tres conceptos clave de este capítulo, los protocolos de la capa de aplicación, la arquitectura de las aplicaciones de red 2, y los sockets que permiten la interacción entre la capa de aplicación y la capa de transporte. En los siguientes apartados profundizaremos en estos temas. Primero, veremos en detalle los sockets. Después, indagaremos en las arquitecturas de aplicaciones en red. Posteriormente veremos protocolos utilizados en la actualidad como HTTP que utilizamos cuando navegamos por la web, SMTP, IMAP y POP que utilizamos en las aplicaciones de correo, entre otros.
6.1 Socket
Los sockets son la interfaz de programación que permite a las aplicaciones comunicarse con la capa de transporte. Actúan como un punto de conexión bidireccional entre la capa de aplicación y la capa de transporte, proporcionando una abstracción que oculta los detalles de bajo nivel de la comunicación en red. En esencia, un socket es un endpoint de comunicación que permite que los procesos intercambien datos, ya sea en la misma máquina o a través de una red. La API de sockets fue introducida en BSD4.1 UNIX en 1981. Los sockets son creados, usados y liberados explícitamente por las aplicaciones. Está basada en el paradigma cliente/servidor.
Cuando una aplicación necesita comunicarse a través de la red, crea un socket que especifica el protocolo de transporte a utilizar (TCP o UDP), la dirección IP del host de destino, y el número de puerto del proceso receptor. El socket encapsula toda la información necesaria para establecer y mantener una conexión de red, proporcionando una interfaz uniforme independientemente del protocolo de transporte subyacente. Los sockets se pueden clasificar según el protocolo de transporte que utilizan, siendo los más comunes los sockets TCP y UDP, cada uno con características y casos de uso específicos. Los detalles del funcionamiento interno de TCP y UDP los vimos en el capítulo de la capa de transporte.
Para identificar un proceso se necesita:
- IP del host: Dirección única de 32 bits (IPv4)
- Número de puerto: Asociado con el proceso en el host
- Ejemplos: HTTP (puerto 80), HTTPS (puerto 443), DNS (puerto 53)
Sockets TCP
Los sockets TCP (Transmission Control Protocol) proporcionan una comunicación confiable y orientada a conexión entre procesos. Antes de que los datos puedan ser intercambiados, se debe establecer una conexión explícita entre el cliente y el servidor, lo que garantiza que ambos extremos estén listos para la comunicación. Las características principales del socket TCP son las siguientes:
- Orientado a conexión: Requiere establecer una conexión antes del intercambio de datos.
- Confiabilidad: Garantiza que todos los datos enviados lleguen al destino sin errores y en orden.
- Control de flujo: Evita que el emisor sature al receptor.
- Control de congestión: Adapta la velocidad de envío según las condiciones de la red.
- Full-duplex: Permite comunicación bidireccional simultánea.
Para crear un socket TCP de tipo servidor, es decir, que siempre está activo y está esperando las conexiones de los clientes (arquitectura cliente-servidor), utilizaremos el módulo net de Javascript. Dentro de este módulo, utilizaremos la función “createServer” para crear un socket de tipo servidor de TCP. Posteriormente, utilizaremos el método “listen” para escuchar en un puerto en concreto. En este caso, el 8888. El segundo parámetro, que en este caso es “localhost”, es opcional, e indica la interfaz local en la que escucha el socket; con “localhost” solo se aceptan conexiones desde la propia máquina (loopback). Si obviamos el parámetro, el socket escuchará en todas las interfaces y los clientes podrán conectarse desde cualquier otra máquina. Finalmente, el último parámetro es un “callback” que se ejecutará una vez el servidor socket esté escuchando en el puerto correctamente.
const net = require('net');

// Crear servidor TCP
const server = net.createServer();

// Configurar el servidor para escuchar en puerto 8888
server.listen(8888, 'localhost', () => {
    console.log('Servidor TCP escuchando en localhost:8888');
});
Por ahora hemos bloqueado un puerto dentro de nuestra máquina y estamos esperando a que se conecten los clientes. Ahora, tenemos que gestionar los eventos de conexión. Para ello, utilizaremos el método “server.on”, especificándole que el evento que queremos escuchar es la conexión “connection” (primer parámetro). El segundo parámetro es un manejador de conexión (una función), que recibe un “socket”, y que será invocada por el servidor socket por cada cliente que se conecte. Recordemos que TCP está orientado a conexión. En nuestro código esa conexión con el cliente se realizará a través del “socket” que recibe el manejador.
// Manejar nuevas conexiones
server.on('connection', (socket) => {
    console.log('Cliente conectado:', socket.remoteAddress);
    // El socket está listo para intercambiar datos
});
Sobre este socket que hemos recibido en el manejador podemos escuchar diferentes eventos. El primer evento que veremos es “data”. Este evento se invocará cada vez que el socket reciba información desde el otro socket. Estos datos se procesan a través de un manejador que le pasaremos cuando escuchamos el evento “data”. El manejador recibirá un parámetro, que en el siguiente código se denomina “data”, y contendrá los datos enviados por el otro integrante de la conexión.
socket.on('data', (data) => {

})
Por contextualizar, supongamos que tenemos un juego con dos jugadores que están en diferentes máquinas y estos se comunican con un servidor central. En este método recibiríamos por ejemplo las actualizaciones de estado de cada uno de los jugadores, y tendríamos que actualizar el estado del servidor y notificar al otro jugador.
El siguiente evento es “close”. Este evento se invocará cuando la conexión se haya cerrado. En el manejador que le pasamos como parámetro tendremos que realizar las operaciones oportunas en base al protocolo que estemos definiendo.
socket.on('close', () => {
    console.log(`[${socket.remoteAddress}] Disconnected`);
});
Siguiendo con el ejemplo, este evento podría invocarse si uno de los jugadores se desconecta. En ese caso, se invocaría ese método, el servidor debería actualizar a finalizado el estado del juego, y notificar al otro jugador de que la partida ha terminado.
Por último, tenemos el evento “error”. Este puede ocurrir cuando se cierra la conexión de forma inesperada, por ejemplo, te desconectas de la red. En este caso también se ejecutará el manejador de “close”, así que es recomendable poner la lógica de limpieza allí, ya que el “close” se ejecutará si la conexión se cierra tanto de forma natural como inesperada, mientras que el “error” solo cuando es de forma inesperada. Otro posible caso en el que se ejecuta el “error” es si estamos tratando de escribir en un socket que está cerrado. También puede ocurrir si salta un evento de “timeout” durante el envío de datos.
socket.on('error', (err) => {
    console.log(`[${socket.remoteAddress}] Error: ${err.message}`);
});
Ahora que sabemos como manejar los eventos, sólo nos falta ver como enviar información a través de un socket. Para ello, utilizaremos el método “write”. El segundo parámetro es un manejador que utilizaremos para capturar los errores durante el envió de información.
socket.write('Hello', (err) => {

});
Este método lo utilizaríamos para enviar por ejemplo las actualizaciones de estado.
Una vez vista la parte del servidor veremos la del cliente. Para ello necesitaremos también el módulo “net” y crearemos un socket con “new net.Socket()”. Una vez creado el socket, lo conectaremos mediante la instrucción “socket.connect”. El primer parámetro es el puerto donde está escuchando el servidor socket en la máquina identificada por el segundo parámetro. En este caso, la conexión es a “localhost” y el puerto 8888. El tercer parámetro es un callback que se ejecutará una vez la conexión se haya establecido.
const net = require('net');

// Crear socket TCP
const socket = new net.Socket();

// Conectar al servidor (establece la conexión TCP)
socket.connect(8888, 'localhost', () => {
    console.log('Conectado al servidor TCP');
    // El socket está listo para intercambiar datos
});
Respecto a los métodos por la parte del cliente, son los mismos que explicamos con el socket del servidor (es decir, una vez establecida la conexión). Una vez se establece la conexión, no hay diferencia entre ambos. Como matiz, en el manejador de error del cliente tenemos algunos errores a mayores, como por ejemplo si no se puede establecer la conexión.
Ambos socket tienen que ser cerrados para liberar recursos una vez hayamos terminado. Para ello, en el socket del cliente utilizaremos el método “end”:
socket.end()En el caso del servidor, el método “close”:
server.close()Si no lo hacemos el bucle de eventos seguirá activo y la aplicación no terminará.
Sockets UDP
Los sockets UDP (User Datagram Protocol) proporcionan una comunicación sin conexión y de mejor esfuerzo. El mejor esfuerzo se refiere a que va a intentar lo mejor que pueda enviar la información al destinatario, pero en caso de que falle, no va a volver a intentarlo ni te notificará. Esto contrasta con TCP que si lo reintenta y en caso de no poder te notifica. Sus características principales son las siguientes:
- Sin conexión: No requiere establecer conexión previa
- Mejor esfuerzo: No garantiza entrega, orden ni integridad de datos
- Baja latencia: Menor overhead que TCP
- Simplicidad: Protocolo más simple y directo
- Broadcast/Multicast: Soporte nativo para envío a múltiples destinatarios
Para recibir paquetes de UDP, crearemos un servidor de UDP utilizando el paquete “dgram”. El socket se crea mediante la expresión “dgram.createSocket(‘udp4’)”. En este caso se utiliza “udp4” ya que utilizamos IPv4, pero si queremos utilizar IPv6 sería “udp6”. Vimos las diferencias en el capítulo de capa de red. Una vez creado el socket, nos mantenemos a la escucha con la instrucción “bind”. En este caso, el puerto 8888. El segundo parámetro, en este caso “localhost”, indica la interfaz local en la que escucha el socket; con “localhost” solo aceptaremos peticiones desde la propia máquina (loopback). Como en TCP, si lo dejamos vacío escuchará en todas las interfaces. También podremos especificar otras interfaces. Finalmente tenemos un manejador que se invocará si el socket empieza a escuchar en el puerto 8888 correctamente.
const dgram = require('dgram');

// Crear socket UDP
const server = dgram.createSocket('udp4');

// Vincular el socket al puerto 8888
server.bind(8888, 'localhost', () => {
    console.log('Servidor UDP escuchando en localhost:8888');
});
Para recibir mensajes, añadimos un manejador al evento “message”. Este manejador recibe dos parámetros. El mensaje, que es lo que nos han enviado desde el socket UDP cliente y el parámetro rinfo, que contiene la información necesaria para identificar el socket que nos envía información.
// Escuchar mensajes entrantes
server.on('message', (msg, rinfo) => {
    console.log(`Mensaje recibido de ${rinfo.address}:${rinfo.port}`);
    // No hay conexión establecida, cada mensaje es independiente
});
También podremos añadir un manejador de errores con el evento “error”. Los errores podrían ser que no se puede hacer el bind al puerto. Esto puede ocurrir si el puerto ya está en uso o es un puerto reservado y no tenemos los permisos necesarios.
server.on('error', (err) => {
    console.error('Socket error:', err.message);

});
Para enviar los mensajes, tendremos que crear un socket con el módulo “dgram”. Posteriormente, utilizaremos “createSocket” para crear el socket cliente que nos permitirá enviar información.
const dgram = require('dgram');

// Crear socket UDP
const client = dgram.createSocket('udp4');
Para enviar la información utilizaremos el método send. Como no tenemos una conexión como en TCP, cada vez que enviemos información tenemos que indicarle cuál es el puerto de destino (8888) y la IP de destino (localhost). El manejador se invocará indicándonos si ha habido un error durante el envío o no. Algunos errores pueden ser que el destino no se pueda alcanzar, que el buffer de UDP esté lleno, entre otros. Como hemos comentado, que el mensaje se haya enviado no quiere decir que el destinatario lo reciba.
client.send('Hola servidor UDP', 8888, 'localhost', (err) => {
    if (err) throw err;
    console.log('Mensaje enviado al servidor UDP');
});
Una pregunta que os puede surgir con UDP es, ¿Cómo le escribe de vuelta el actual “servidor” al “cliente”? La respuesta es simple, invirtiendo los roles. Cuando creamos nuestro “socket cliente” sin decirle que haga un bind a un puerto determinado, cuando enviamos un mensaje se hace un bind a un puerto aleatorio que esté libre. A través del “rinfo” anterior tenemos tanto “rinfo.address” como “rinfo.port” que son la IP y el puerto. Por lo tanto, podemos escribir al cliente utilizando esa información.
Para recepcionar ese mensaje, en el cliente tendríamos que escuchar el evento de “message”:
client.on('message', (msg, rinfo) => {
    console.log(`Mensaje recibido de ${rinfo.address}:${rinfo.port}`);
    // No hay conexión establecida, cada mensaje es independiente
});
y también podríamos como hicimos antes capturar el evento de errores. Con esto podemos llegar a una interesante conclusión. Tanto el socket del cliente como el del servidor son iguales. La única diferencia es que en el servidor, le indicamos especificamente en que puerto queremos escuchar. Esto lo hacemos para facilitar que los demás sepan donde está ubicado. En el caso del cliente no tenemos esa necesidad. Podemos escoger un puerto aleatorio. Cuando enviemos un mensaje al servidor el sabrá el puerto del cliente y podrá escribirle también.
Finalmente, es necesario cerrar tanto el cliente:
client.close()como el servidor
server.close()Si no el bucle de eventos seguirá activo y la ejecución no terminará. También se liberarán los recursos.
Servicios Requeridos y elección de capa de transporte
Las aplicaciones de red tienen diferentes requisitos en cuanto a los servicios que necesitan de la capa de transporte. Estos requisitos determinan qué protocolo de transporte es más apropiado para cada aplicación específica.
Transferencia Confiable: Algunas aplicaciones requieren que todos los datos enviados lleguen al destino sin errores ni pérdidas. Esta característica es fundamental para aplicaciones donde la integridad de la información es crítica. Ejemplos de aplicaciones que requieren una confiabilidad total son la transferencia de archivos, correo electrónico, navegación web, banca online, comercio electrónico. En estos casos, la pérdida de datos podría resultar en archivos corruptos, mensajes incompletos o transacciones fallidas. Por otra parte, algunas aplicaciones son tolerantes a la pérdida de información, como el streaming de audio/vídeo, videoconferencias, juegos en tiempo real. Estas aplicaciones pueden funcionar adecuadamente incluso si se pierden algunos paquetes ocasionalmente, ya que el contenido perdido puede ser interpolado o simplemente ignorado sin afectar significativamente la experiencia del usuario.
Temporización (Timing): El tiempo de respuesta es crucial para aplicaciones interactivas y en tiempo real. Algunas aplicaciones son sensibles a la latencia, como los juegos multijugador online, trading de alta frecuencia, aplicaciones de realidad virtual, control remoto de dispositivos. Estas aplicaciones requieren tiempos de respuesta muy bajos (típicamente menos de 50-100ms) para proporcionar una experiencia fluida. En otros casos no es tan importante, como en el correo electrónico, transferencia de archivos en segundo plano, respaldos automáticos. Estas aplicaciones pueden funcionar correctamente con latencias más altas sin afectar significativamente la experiencia del usuario.
Ancho de Banda: Las necesidades de ancho de banda varían enormemente entre aplicaciones. Ejemplos de aplicaciones sensibles al ancho de banda son el streaming de vídeo 4K/8K, videoconferencias de alta calidad, transferencia de archivos grandes, respaldos de bases de datos. Estas aplicaciones requieren una tasa mínima garantizada de transferencia para funcionar correctamente. Cuando una aplicación no es sensible, a veces se denominan elásticas, es decir, estas aplicaciones pueden adaptarse al ancho de banda disponible, funcionando más lento con conexiones limitadas pero manteniéndose operativas. Algunos ejemplos son: Navegación web, correo electrónico, mensajería instantánea.
Seguridad: Los requisitos de seguridad incluyen varios aspectos:
- Confidencialidad: Garantizar que solo los destinatarios autorizados puedan leer los datos (mediante cifrado).
- Integridad: Asegurar que los datos no han sido modificados durante la transmisión.
- Autenticación: Verificar la identidad de las partes que se comunican.
- No repudio: Garantizar que el emisor no pueda negar haber enviado los datos.
Aplicaciones como banca online, comercio electrónico, mensajería privada y transferencia de documentos confidenciales requieren múltiples aspectos de seguridad, mientras que aplicaciones como streaming público o noticias pueden tener requisitos de seguridad más relajados.
La elección entre sockets TCP y UDP depende de los requisitos específicos de la aplicación:
Usar TCP cuando:
- La integridad de datos es crítica
- Se necesita garantizar el orden de los mensajes
- La aplicación puede tolerar mayor latencia
- Se transfieren archivos o datos importantes
Usar UDP cuando:
- La velocidad y baja latencia son prioritarias
- La aplicación puede manejar pérdida ocasional de datos
- Se implementan aplicaciones en tiempo real
- Se necesita comunicación multicast o broadcast
Algunos ejemplos de elección son los siguientes:
| Aplicación | Confiabilidad | Temporización | Ancho de Banda | Seguridad | Protocolo Típico |
|---|---|---|---|---|---|
| Transferencia de archivos | Sí | No crítica | Elástica | Según contenido | TCP |
| Correo electrónico | Sí | No crítica | Elástica | Sí | TCP |
| Navegación web | Sí | Moderada | Elástica | Sí (HTTPS) | UDP (HTTP/3) / TCP (HTTP/1.1-2) |
| Streaming de vídeo | Tolerante | Crítica | Mínima garantizada | Según contenido | UDP/TCP |
| Juegos en tiempo real | Tolerante | Muy crítica | Moderada | Sí | UDP |
| Videoconferencia | Tolerante | Crítica | Mínima garantizada | Sí | UDP/TCP |
| DNS | Tolerante | Crítica | Elástica | Creciente (DoH/DoT) | UDP/TCP |
En esta tabla igual hay un detalle que os llama la atención. Hemos dicho que UDP no es confiable. Se puede perder información o incluso llegar en distinto orden. Sin embargo, en la navegación web que requiere de confiabilidad, se indica que se utiliza UDP cuando el protocolo es HTTP/3. ¿Cómo es esto posible? La respuesta es QUIC, que veremos posteriormente en este capítulo. Lo interesante en este caso es darnos cuenta de que podemos tener una comunicación confiable (QUIC) a través de un medio no confiable (UDP). Para ello, el protocolo QUIC añade una nueva capa (encapsular) con la información y lógica necesaria para garantizar la confiabilidad en ambos extremos. Otra forma de verlo es que a veces podemos movernos entre TCP y UDP añadiendo los requisitos que necesitemos a UDP, que es el protocolo más básico, y evitar algunas de las desventajas de TCP.
6.2 Arquitecturas de Aplicaciones Distribuidas
Las arquitecturas en las aplicaciones distribuidas, es decir, con más de un nodo, indican cómo se conectan entre sí los nodos y cuál será el rol de cada uno de los nodos. A grandes rasgos, distinguimos tres tipos de arquitecturas: cliente - servidor, peer-to-peer e híbrida. La arquitectura cliente - servidor la mencionamos en el ejemplo anterior. En el caso de peer-to-peer, tenemos un conjunto de nodos que se conectan entre sí. La topología de las conexiones no tiene por qué ser un grafo completo, y puede variar a lo largo del tiempo. En este caso la funcionalidad está distribuida por los nodos. Un ejemplo de peer-to-peer es BitTorrent. Finalmente, las arquitecturas híbridas son una mezcla entre ambas, teniendo generalmente autoridades centrales que permiten mantener la red en funcionamiento, o determinadas funcionalidades. Las arquitecturas híbridas son más comunes que las puramente peer-to-peer.
En los siguientes apartados exploraremos estas tres arquitecturas, así como las aplicaciones populares y juegos para cada una de ellas.
Arquitectura Cliente/Servidor
La arquitectura cliente-servidor es un modelo fundamental de computación distribuida donde múltiples clientes solicitan servicios, recursos o datos de un servidor centralizado. En este paradigma, el servidor actúa como el punto central de control y coordinación, mientras que los clientes consumen los servicios proporcionados. Esta arquitectura se caracteriza por tener un host siempre activo (el servidor) que atiende las peticiones de numerosos hosts clientes, los cuales pueden conectarse y desconectarse dinámicamente sin afectar el funcionamiento del sistema. Los clientes poseen direcciones IP dinámicas y no se comunican directamente entre sí, sino que toda la comunicación se canaliza a través del servidor.
En el funcionamiento típico de esta arquitectura, el cliente inicia la comunicación enviando una solicitud al servidor, especificando qué servicio o recurso necesita. El servidor procesa esta petición, accede a los datos o recursos necesarios, y envía una respuesta de vuelta al cliente. Este modelo permite la centralización de recursos, datos y lógica de negocio, facilitando el mantenimiento, la seguridad y la consistencia del sistema. El servidor debe tener una dirección IP fija y conocida para que los clientes puedan localizarlo, y típicamente opera de forma continua para estar disponible cuando los clientes lo necesiten.
Los requerimientos de infraestructura para sistemas cliente-servidor populares son considerables. Los servidores deben ser capaces de manejar múltiples conexiones simultáneas, procesar grandes volúmenes de datos y mantener alta disponibilidad. Esto frecuentemente requiere centros de datos con clusters de servidores, sistemas de balanceamiento de carga, redundancia y respaldo, así como conexiones de red de alto ancho de banda. Para aplicaciones con millones de usuarios, como las redes sociales o servicios de streaming, la infraestructura puede incluir múltiples centros de datos distribuidos geográficamente para optimizar la latencia y garantizar la disponibilidad del servicio.
Ejemplos cotidianos de arquitectura cliente-servidor incluyen aplicaciones web como Netflix, donde el cliente (navegador web o aplicación móvil) solicita contenido de vídeo al servidor, que almacena y transmite las películas y series. Spotify funciona de manera similar, donde los clientes solicitan canciones y playlists que están almacenadas en los servidores de la plataforma. Instagram representa otro caso típico donde los clientes suben fotos y vídeos a los servidores, y otros usuarios pueden solicitar y visualizar este contenido. Los servicios de correo electrónico como Gmail operan bajo este modelo, donde los servidores almacenan y gestionan los mensajes mientras los clientes acceden a ellos a través de aplicaciones web o móviles.
En el contexto de los videojuegos, la arquitectura cliente-servidor se ha convertido en el estándar para juegos multijugador masivos y competitivos. El servidor mantiene el estado autoritativo del juego, procesando todas las acciones de los jugadores y distribuyendo las actualizaciones correspondientes. Los clientes se encargan principalmente de la presentación visual, la captura de entrada del usuario y la comunicación con el servidor. Esta separación permite que el servidor tenga control total sobre la lógica del juego, previniendo trampas y garantizando la coherencia del estado del juego entre todos los participantes.
Ejemplos típicos de esta arquitectura incluyen juegos como World of Warcraft, donde miles de jugadores se conectan a servidores dedicados que mantienen mundos persistentes. Counter-Strike 2 utiliza servidores dedicados para partidas competitivas, asegurando que todas las acciones sean validadas centralmente. League of Legends emplea esta arquitectura para sus partidas clasificatorias, donde el servidor procesa todos los movimientos, ataques y habilidades de los campeones. Fortnite Battle Royale también implementa servidores dedicados para mantener la sincronización entre los 100 jugadores en cada partida.
Los juegos de estrategia en tiempo real como StarCraft II y Age of Empires IV también adoptan esta arquitectura para sus modos multijugador competitivos. En estos casos, el servidor procesa todas las órdenes de construcción, movimiento de unidades y combates, garantizando que ambos jugadores vean exactamente el mismo estado del juego. Los MMORPGs como Final Fantasy XIV y Guild Wars 2 son ejemplos perfectos donde el servidor no solo mantiene el estado del juego sino también la persistencia de los personajes, inventarios y progreso de los jugadores.
Uno de los principales problemas en juegos cliente-servidor es la latencia o “lag”, que se refiere al tiempo que tarda una acción del jugador en ser procesada por el servidor y reflejada de vuelta al cliente. Esta latencia puede causar una experiencia de juego frustrante, especialmente en juegos de acción rápida como shooters en primera persona. Para mitigar este problema, muchos juegos implementan técnicas como la predicción del lado del cliente, donde el cliente asume temporalmente el resultado de una acción antes de recibir la confirmación del servidor.
El problema de la sincronización es otro desafío crítico en los juegos cliente-servidor. Cuando múltiples jugadores interactúan simultáneamente, el servidor debe procesar las acciones en un orden específico y comunicar los resultados a todos los clientes de manera coherente. Los juegos como Rocket League han tenido que implementar sistemas sofisticados de interpolación y extrapolación para mantener la fluidez del juego mientras se sincronizan las posiciones de la pelota y los vehículos entre todos los jugadores.
Los servidores sobrecargados representan un problema significativo, especialmente durante los lanzamientos de juegos populares o eventos especiales. Diablo III experimentó problemas masivos en su lanzamiento debido a que sus servidores no podían manejar la cantidad de jugadores conectados simultáneamente. World of Warcraft ha enfrentado desafíos similares durante las expansiones, donde millones de jugadores intentan conectarse al mismo tiempo, causando colas de conexión y caídas del servidor.
La pérdida de conexión con el servidor es otro problema común que puede arruinar la experiencia de juego. En juegos competitivos como Dota 2 o Overwatch, una desconexión del servidor puede resultar en penalizaciones para el jugador, incluso si la falta no fue suya. Los desarrolladores han implementado sistemas de reconexión automática y buffers de tolerancia para minimizar el impacto de desconexiones temporales, pero el problema persiste como una limitación inherente del modelo cliente-servidor.
Los costes de infraestructura representan un desafío económico significativo para los desarrolladores de juegos que adoptan esta arquitectura. Mantener granjas de servidores, centros de datos distribuidos globalmente y el ancho de banda necesario para soportar millones de jugadores concurrentes requiere inversiones masivas. Epic Games, por ejemplo, ha invertido cientos de millones de dólares en infraestructura para soportar Fortnite, incluyendo partnerships con proveedores de servicios en la nube como Amazon Web Services para escalar dinámicamente según la demanda.
A pesar de estos desafíos, la arquitectura cliente-servidor sigue siendo la opción preferida para juegos multijugador serios debido a sus ventajas en términos de seguridad, control y escalabilidad. Los avances en tecnologías de red, computación en la nube y técnicas de optimización continúan mejorando la viabilidad de esta arquitectura. Los desarrolladores modernos implementan soluciones híbridas que combinan servidores dedicados con técnicas de peer-to-peer para diferentes aspectos del juego, optimizando tanto la experiencia del jugador como los costes operativos.
Arquitectura Peer-to-Peer (P2P)
La arquitectura peer-to-peer (P2P) es un modelo de computación distribuida donde los participantes (pares o peers) comparten recursos directamente entre sí sin depender de servidores centralizados. A diferencia del modelo cliente-servidor, en P2P no existe una entidad central que controle o coordine las comunicaciones; en su lugar, cada participante actúa simultáneamente como cliente y servidor, compartiendo y consumiendo recursos de manera equitativa. Esta arquitectura se caracteriza por la ausencia de dependencia de servidores siempre activos, permitiendo que los pares se conecten de forma intermitente y estableciendo comunicación directa entre ellos.
El funcionamiento de las redes P2P se basa en la colaboración voluntaria de los participantes, donde cada peer contribuye con recursos computacionales, de almacenamiento o ancho de banda al conjunto de la red. Los peers pueden unirse o abandonar la red libremente sin comprometer significativamente su funcionamiento, ya que la arquitectura es inherentemente autoescalable: cuantos más participantes se unen, más recursos totales están disponibles. Esta característica contrasta marcadamente con los sistemas centralizados, donde el servidor puede convertirse en un cuello de botella cuando aumenta el número de usuarios.
Existen diferentes clasificaciones de arquitecturas P2P según su nivel de pureza y estructura:
Por pureza, encontramos sistemas centralizados como Napster (que dependía de un servidor central para indexar archivos) y BitTorrent (que utiliza trackers centrales para coordinar descargas), versus sistemas completamente descentralizados como Freenet y Gnutella, que no dependen de ningún equipo específico para su funcionamiento.
Por paridad, las redes pueden ser estructuradas, donde existen categorías específicas de nodos con control sobre la estructura de la red, o desestructuradas, donde las conexiones y la topología emergen de manera arbitraria según las decisiones individuales de cada peer.
También existen diferentes tipos de topologías:
La topología Full Mesh es la más robusta pero también la más demandante en términos de recursos, ya que cada peer se conecta directamente con todos los demás participantes de la red. Esta configuración ofrece la máxima redundancia y la latencia más baja posible entre cualquier par de nodos, pero el número de conexiones crece cuadráticamente con cada nuevo participante, haciendo que sea práctica solo para grupos muy pequeños de peers.
La topología Ring organiza los peers en una estructura circular donde cada nodo se conecta únicamente con sus vecinos inmediatos, formando un anillo cerrado. Los datos viajan alrededor del anillo hasta llegar a su destino, lo que puede introducir latencia variable dependiendo de la distancia entre peers en la estructura circular. Esta topología es más eficiente en términos de conexiones que el full mesh, pero presenta vulnerabilidades ya que la falla de un solo peer puede interrumpir la comunicación en todo el anillo, aunque existen implementaciones bidireccionales que mitigan este riesgo.
La topología Star representa un enfoque pseudo-P2P donde un peer central actúa como hub para todos los demás participantes. Aunque técnicamente sigue siendo P2P porque no requiere un servidor dedicado, esta configuración introduce un punto único de falla en el peer central. Sin embargo, es la más eficiente en términos de gestión de conexiones y sincronización, ya que reduce significativamente la complejidad de coordinación. Es común en juegos cooperativos donde el host del juego actúa como el nodo central, gestionando el estado del juego y redistribuyendo información a los otros jugadores.
Las topologías Híbridas combinan elementos de diferentes enfoques según los requerimientos específicos del juego o aplicación. Por ejemplo, un juego podría usar una topología de star para la lógica principal del juego mientras implementa conexiones mesh directas para comunicación de voz entre jugadores. Estas implementaciones permiten optimizar diferentes aspectos del rendimiento, balanceando latencia, confiabilidad y eficiencia de recursos según las necesidades particulares de cada función dentro del sistema P2P.
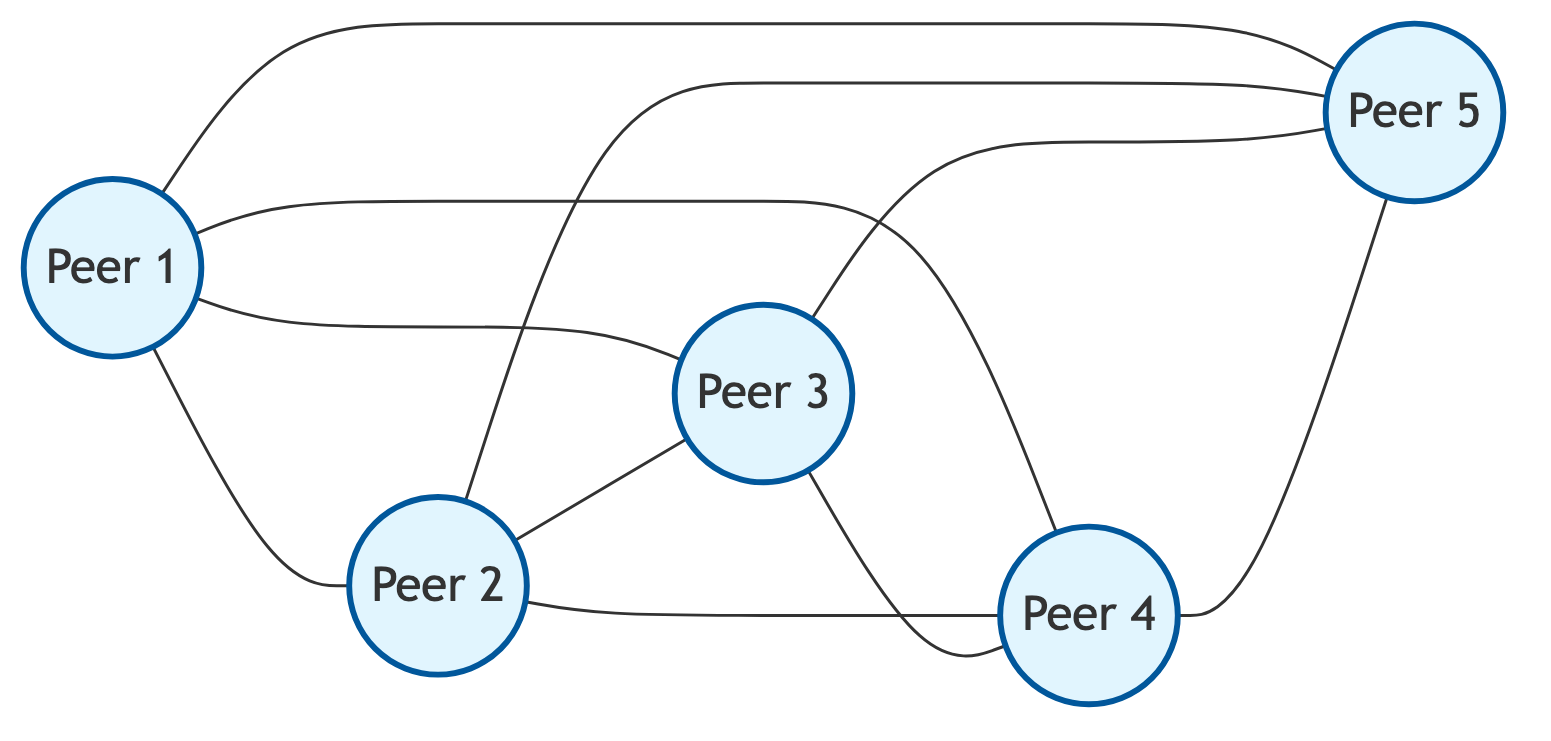
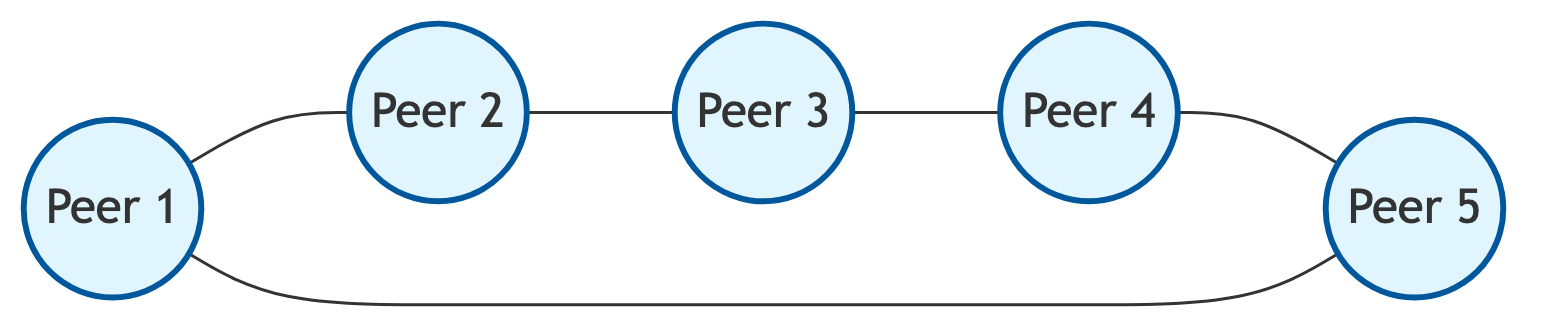
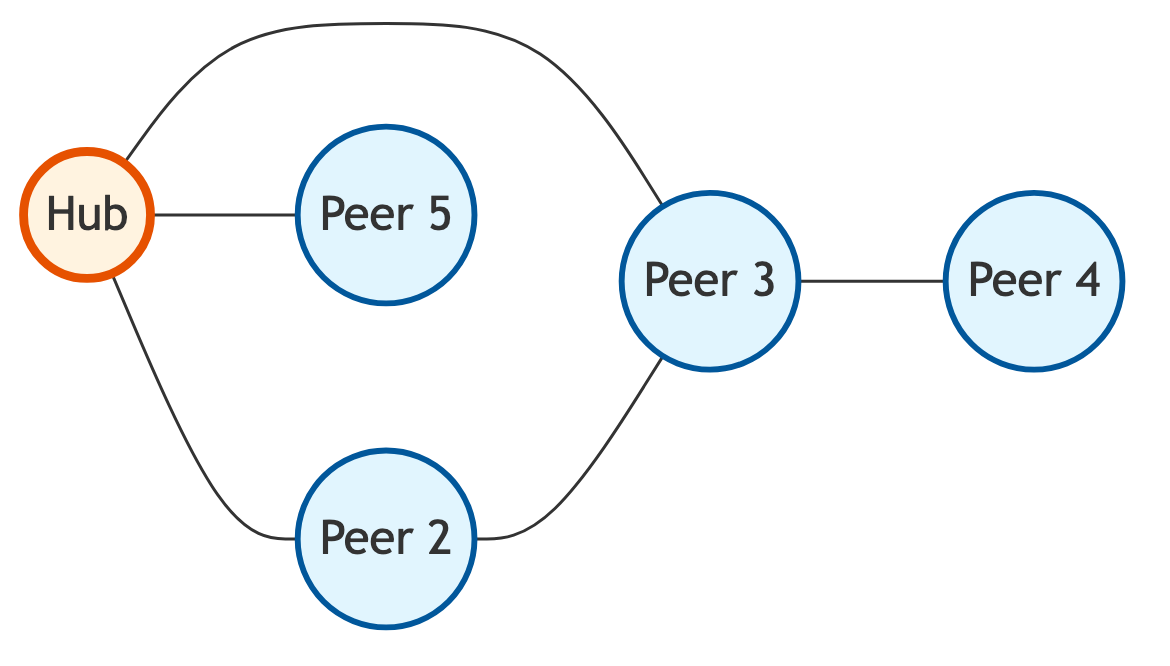
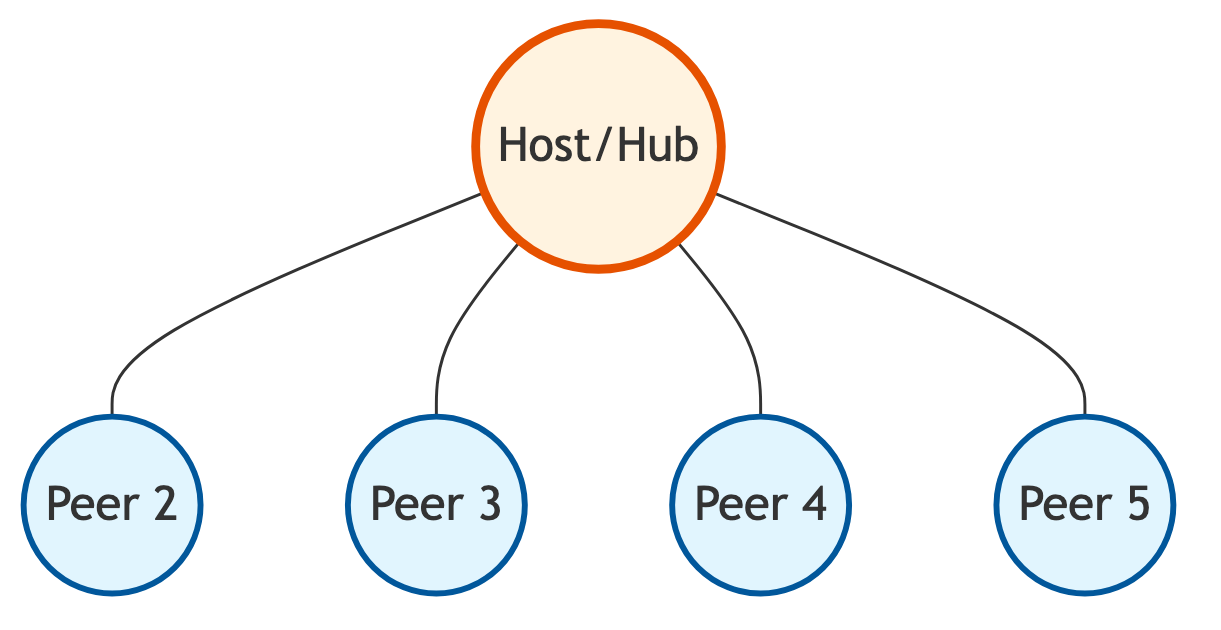
Las aplicaciones cotidianas de P2P incluyen sistemas de compartición de archivos como BitTorrent, donde los usuarios descargan fragmentos de archivos desde múltiples peers simultáneamente, distribuyendo la carga y mejorando la velocidad de descarga. Skype utilizó originalmente arquitectura P2P (similar a la arquitectura híbrida en Figura 6.3) para enrutar llamadas de voz a través de la red de usuarios, aprovechando el ancho de banda y poder computacional distribuido. Las criptomonedas como Bitcoin operan sobre redes P2P completamente descentralizadas, donde cada nodo mantiene una copia del blockchain y participa en la validación de transacciones. Los sistemas de mensajería como Tox y Briar implementan comunicación P2P directa para garantizar privacidad y resistencia a la censura.
Las redes de distribución de contenido P2P como IPFS (InterPlanetary File System) permiten almacenar y distribuir información de manera descentralizada, donde cada participante contribuye espacio de almacenamiento y ancho de banda. Los juegos masivos como algunos servidores privados de World of Warcraft han experimentado con arquitecturas P2P para distribuir actualizaciones y contenido. Las aplicaciones de videoconferencia como Jitsi Meet pueden operar en modo P2P para llamadas pequeñas, estableciendo conexiones directas entre participantes para reducir latencia y eliminar la dependencia de servidores centrales.
En el contexto de los videojuegos, la arquitectura P2P ofrece ventajas únicas pero también presenta desafíos específicos. Los juegos P2P eliminan la necesidad de servidores dedicados, reduciendo costos operativos y permitiendo que los jugadores continúen partidas incluso si los servidores oficiales están fuera de línea. Esta arquitectura es especialmente efectiva en juegos con pocos participantes donde la latencia directa entre jugadores puede ser menor que la latencia a un servidor centralizado. Cada peer mantiene su propia copia del estado del juego y sincroniza cambios con otros participantes.
Los juegos de lucha como Street Fighter 6, Tekken 8 y Guilty Gear Strive utilizan arquitecturas P2P sofisticadas con tecnología de rollback netcode. En estos juegos, ambos jugadores mantienen una simulación completa del combate y sincronizan entradas periódicamente. Cuando hay discrepancias debido a latencia, el sistema “retrocede” el estado del juego y lo recalcula con la información correcta, creando una experiencia fluida incluso con conexiones imperfectas. Esta implementación es ideal para juegos 1v1 donde la latencia directa entre jugadores suele ser menor que la latencia a un servidor dedicado.
Los juegos cooperativos como Portal 2, It Takes Two y A Way Out aprovechan las ventajas de P2P para ofrecer experiencias de baja latencia entre un pequeño grupo de jugadores. En estos casos, uno de los peers actúa como “host” manteniendo el estado autoritativo del juego mientras otros se conectan directamente. Esta configuración elimina la necesidad de servidores dedicados para experiencias cooperativas, permitiendo que los desarrolladores ofrezcan funcionalidad multijugador sin costos adicionales de infraestructura. Los juegos de estrategia en tiempo real como Age of Empires II y StarCraft: Brood War originalmente utilizaban P2P, donde todos los jugadores ejecutaban la misma simulación y compartían comandos.
Sin embargo, los juegos P2P enfrentan desafíos significativos en términos de seguridad y prevención de trampas. Dado que cada peer tiene acceso completo al estado del juego, es relativamente fácil para usuarios malintencionados modificar datos o implementar cheats. Los juegos como Dark Souls han experimentado problemas con hackers que pueden modificar estadísticas de personajes o comportamientos del juego. La validación distribuida es compleja y requiere que múltiples peers acuerden sobre la validez de las acciones, lo que puede ser problemático cuando uno de los participantes está haciendo trampa.
La sincronización representa otro desafío mayor en juegos P2P, especialmente cuando el número de participantes aumenta. En juegos con muchos jugadores, cada peer debe comunicarse con todos los demás, creando un crecimiento cuadrático en el tráfico de red. Minecraft multijugador en modo LAN ejemplifica este problema: funciona bien para grupos pequeños pero se vuelve inmanejable con muchos jugadores. Los problemas de conectividad NAT también complican las conexiones P2P, ya que muchos jugadores están detrás de routers y firewalls que impiden conexiones directas, requiriendo técnicas como hole punching o servidores de relay para establecer comunicación entre peers.
6.3 Protocolos
HTTP
HTTP (HyperText Transfer Protocol) es un protocolo público definido en un RFC que sirve para la transferencia de información en la World Wide Web. Es un protocolo de comunicación que permite la transferencia de recursos (como páginas web, imágenes, documentos, etc.) entre clientes (navegadores web) y servidores web a través de Internet. El protocolo utiliza texto legible tanto para los comandos como para las respuestas. El protocolo opera típicamente sobre TCP/IP, utilizando el puerto 80 para conexiones HTTP estándar y el puerto 443 para conexiones HTTPS seguras.
HTTP opera bajo el modelo cliente-servidor, donde los navegadores web (u otros programas) actúan como clientes que solicitan recursos, y los servidores web responden proporcionando el contenido solicitado. Esta arquitectura descentralizada permite que la web sea escalable y resiliente, distribuyendo la carga de trabajo entre diferentes servidores. Además, al ser un protocolo sin estado, se facilita su escalabilidad. Que no tenga estado implica que cada vez que se realiza una petición es completamente independiente de las anteriores.
Cada recurso en el servidor se identifica a través de una URL (Uniform Resource Locator), que especifica no solo la ubicación del recurso sino también el protocolo necesario para acceder a él. Una URL típica como “https://www.ejemplo.com/pagina.html” contiene el protocolo (https), el nombre del host (www.ejemplo.com), y la ruta específica del recurso (/pagina.html). Esta estructura jerárquica permite organizar y localizar millones de recursos de manera eficiente. Las URL pueden referenciar archivos HTML, hojas de estilo CSS, código, binarios, etc.
Las acciones en HTTP están asociadas a un verbo que indica el objeto de las mismas. Los principales son los siguientes:
- GET: Pedir el objeto de la URL al servidor. Es una operación idempotente, si la repetimos varias veces el resultado debería de ser siempre el mismo. No cambia el estado del servidor. El cuerpo del mensaje está vacío. Cuando descargamos imágenes en Instagram o similares, los comentarios, etc lo hacemos a través de GET.
- POST: Se utiliza para pedir/enviar un objeto asociado a una URL cuando este depende de los datos de un formulario. Puede cambiar el estado del servidor. Por ejemplo, cuando nos registramos en una página estaríamos haciendo un POST.
- HEAD: Es igual que el GET pero devuelve solo las cabeceras, sin cuerpo. Se utiliza para comprobar recursos y validar cachés.
- PUT: Nos permite cargar un objeto en la URL. Es una operación idempotente, si la repetimos varias veces el resultado será siempre el mismo.
- DELETE: Borra el recurso asociado a la URL.
Cabe destacar que este uso esperado de los verbos lo tenemos que implementar nosotros. Nada nos quita de hacer que un GET borre cosas, o se utilice para acciones para las que no estaba diseñado. Sin embargo, seguir la especificación nos va a permitir que otros usuarios de nuestra API la puedan utilizar correctamente de una forma más sencilla.
Todas estas acciones, que en la jerga de HTTP se llaman peticiones, tienen asociada una respuesta. Esta respuesta está formada por una línea de estado (con el código de respuesta), las cabeceras, y el cuerpo; las cookies son solo una cabecera (Set-Cookie). Los códigos de respuesta son un identificador numérico de 3 cifras que indica el resultado de la petición y están asociados a un identificador textual. Se dividen en 5 grupos:
- 1XX: Respuesta informativa, señalan que la solicitud está siendo procesada.
- 2XX: Respuesta satisfactoria, la solicitud se recibió, entendió y se completó con éxito. Por ejemplo, 200 OK.
- 3XX: Redirecciones, informan que se necesita tomar una acción adicional para completar la solicitud. Por ejemplo, 301 Moved Permanently: Indica que el recurso se ha movido de forma permanente a una nueva URL.
- 4XX: Error en los clientes, indican un error en la solicitud del cliente, como solicitar un recurso inexistente. Por ejemplo, 400 Bad Request, 403 Forbidden o 404 Not Found.
- 5XX: Error en los servidores, señalan que el servidor no pudo completar una solicitud debido a un error interno. Por ejemplo, 500 Internal Server Error o 503 Service Unavailable.
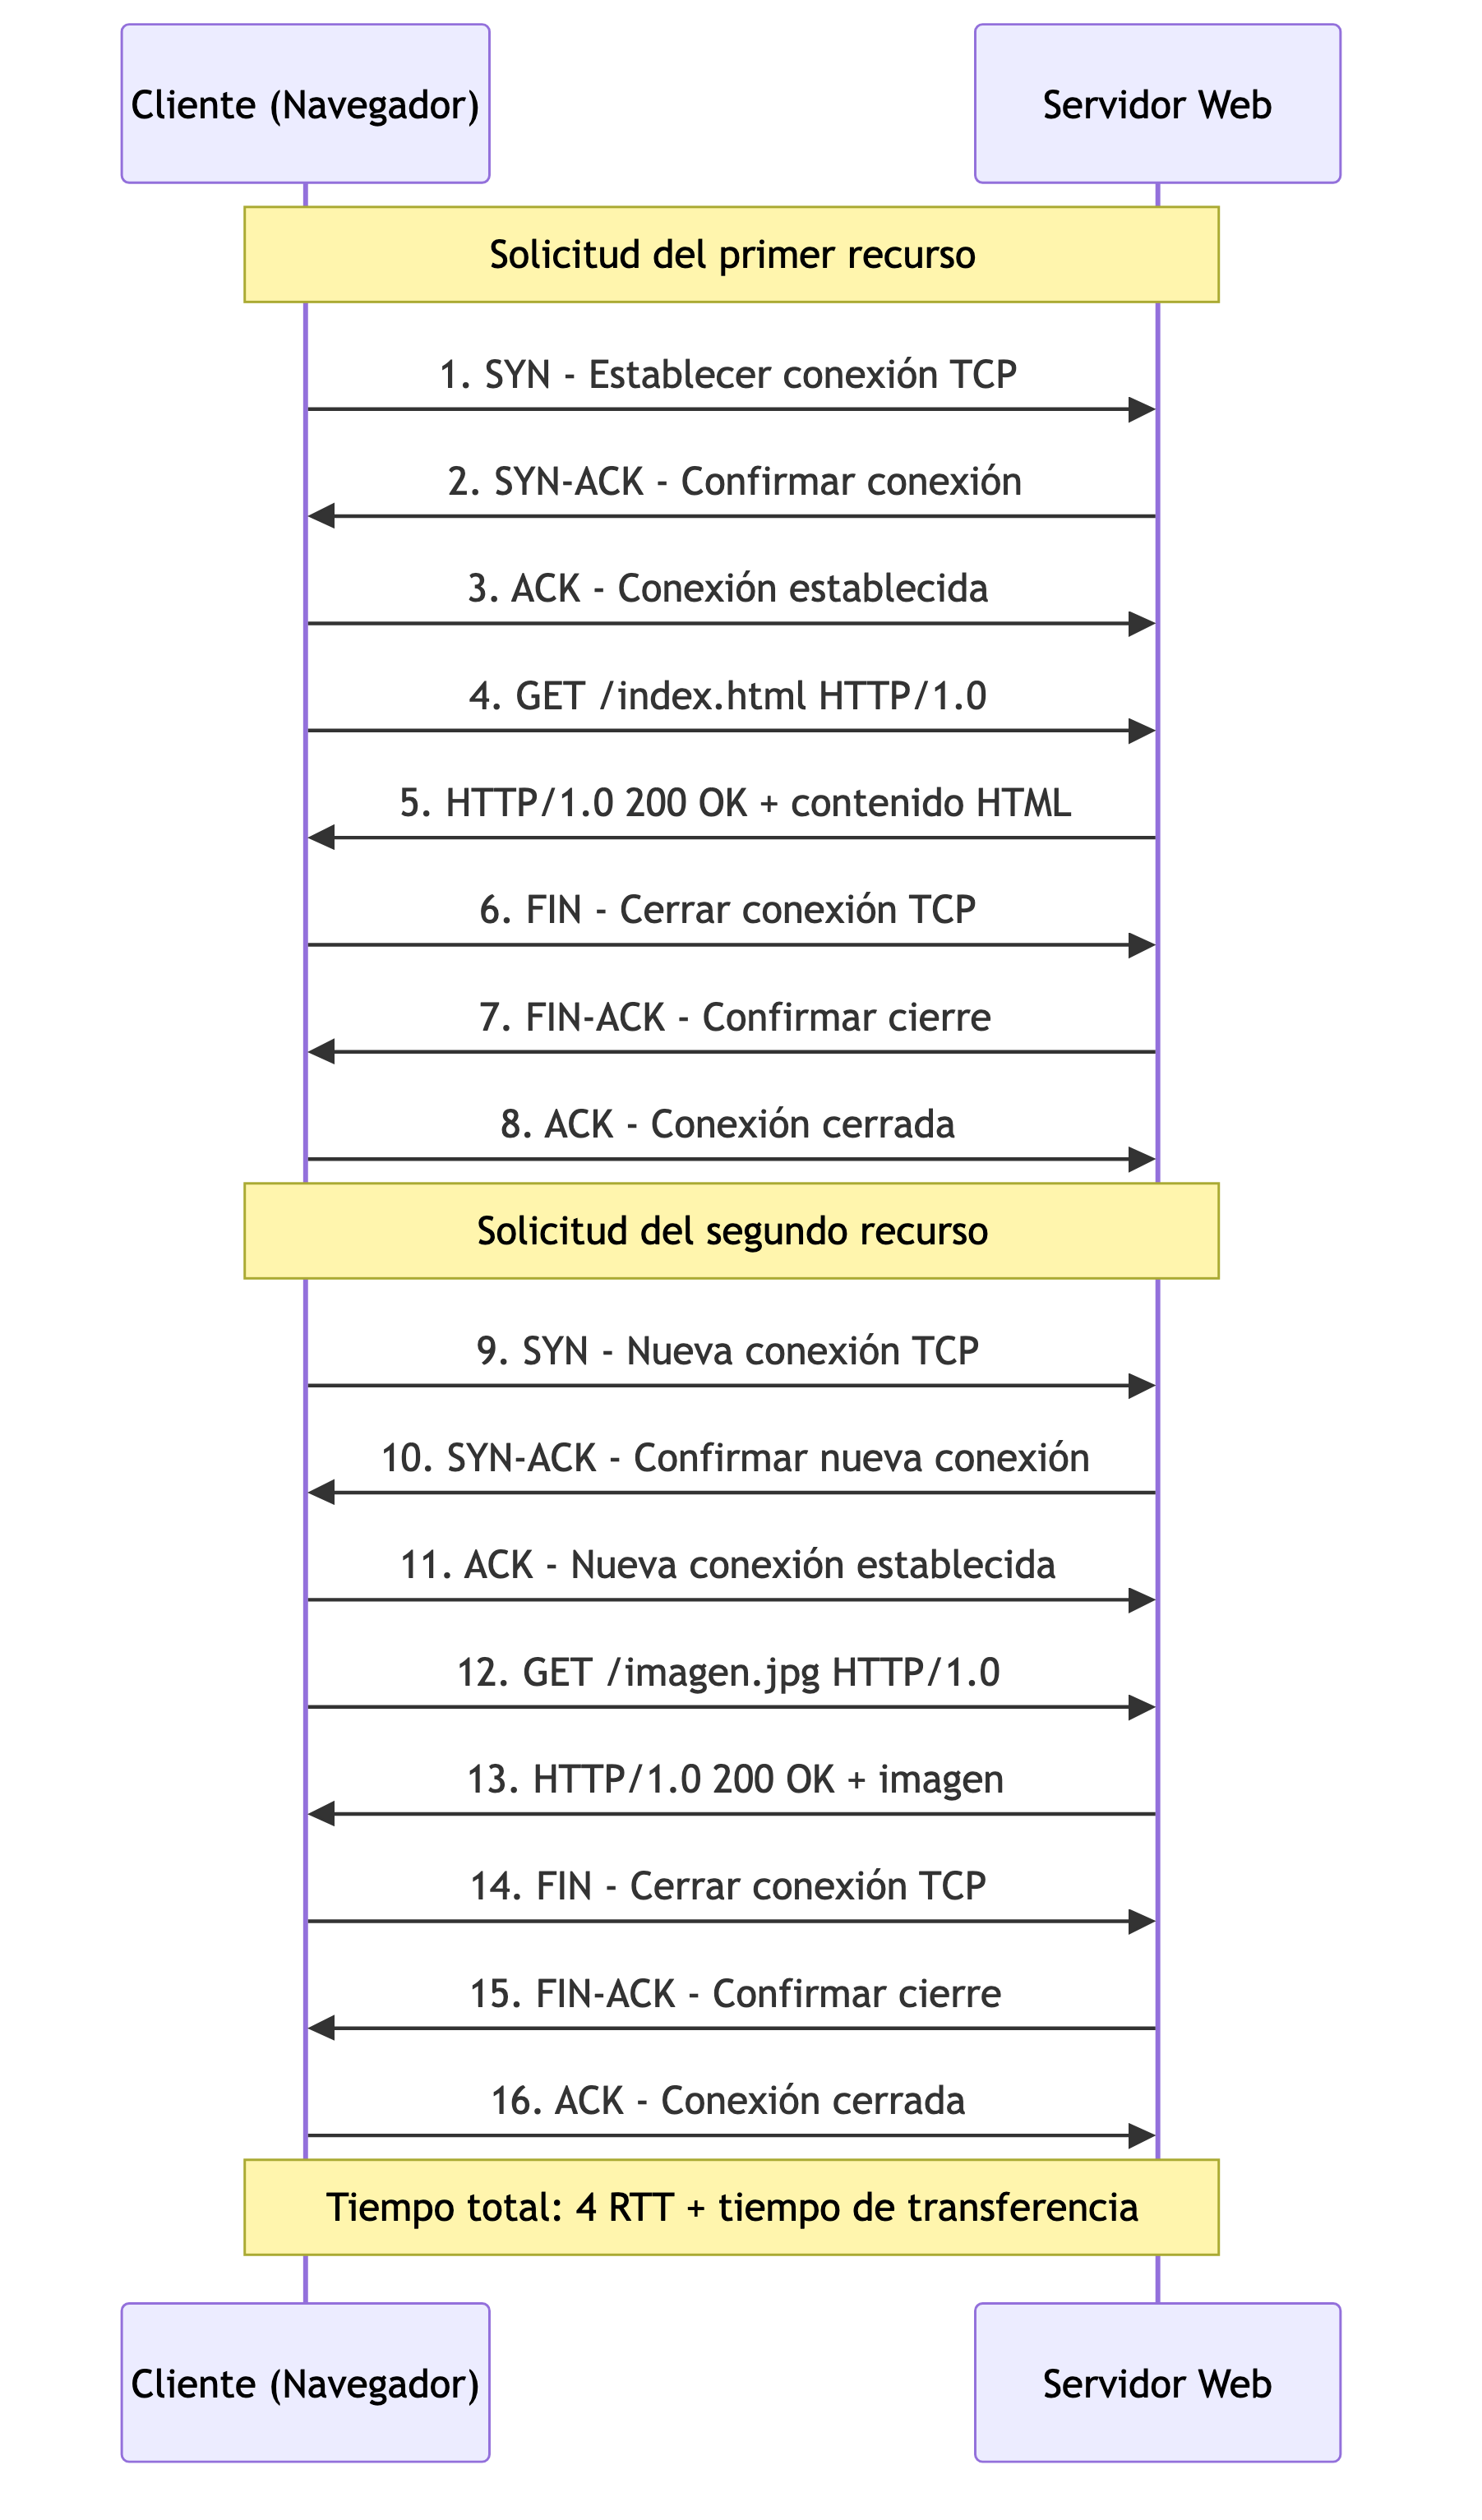
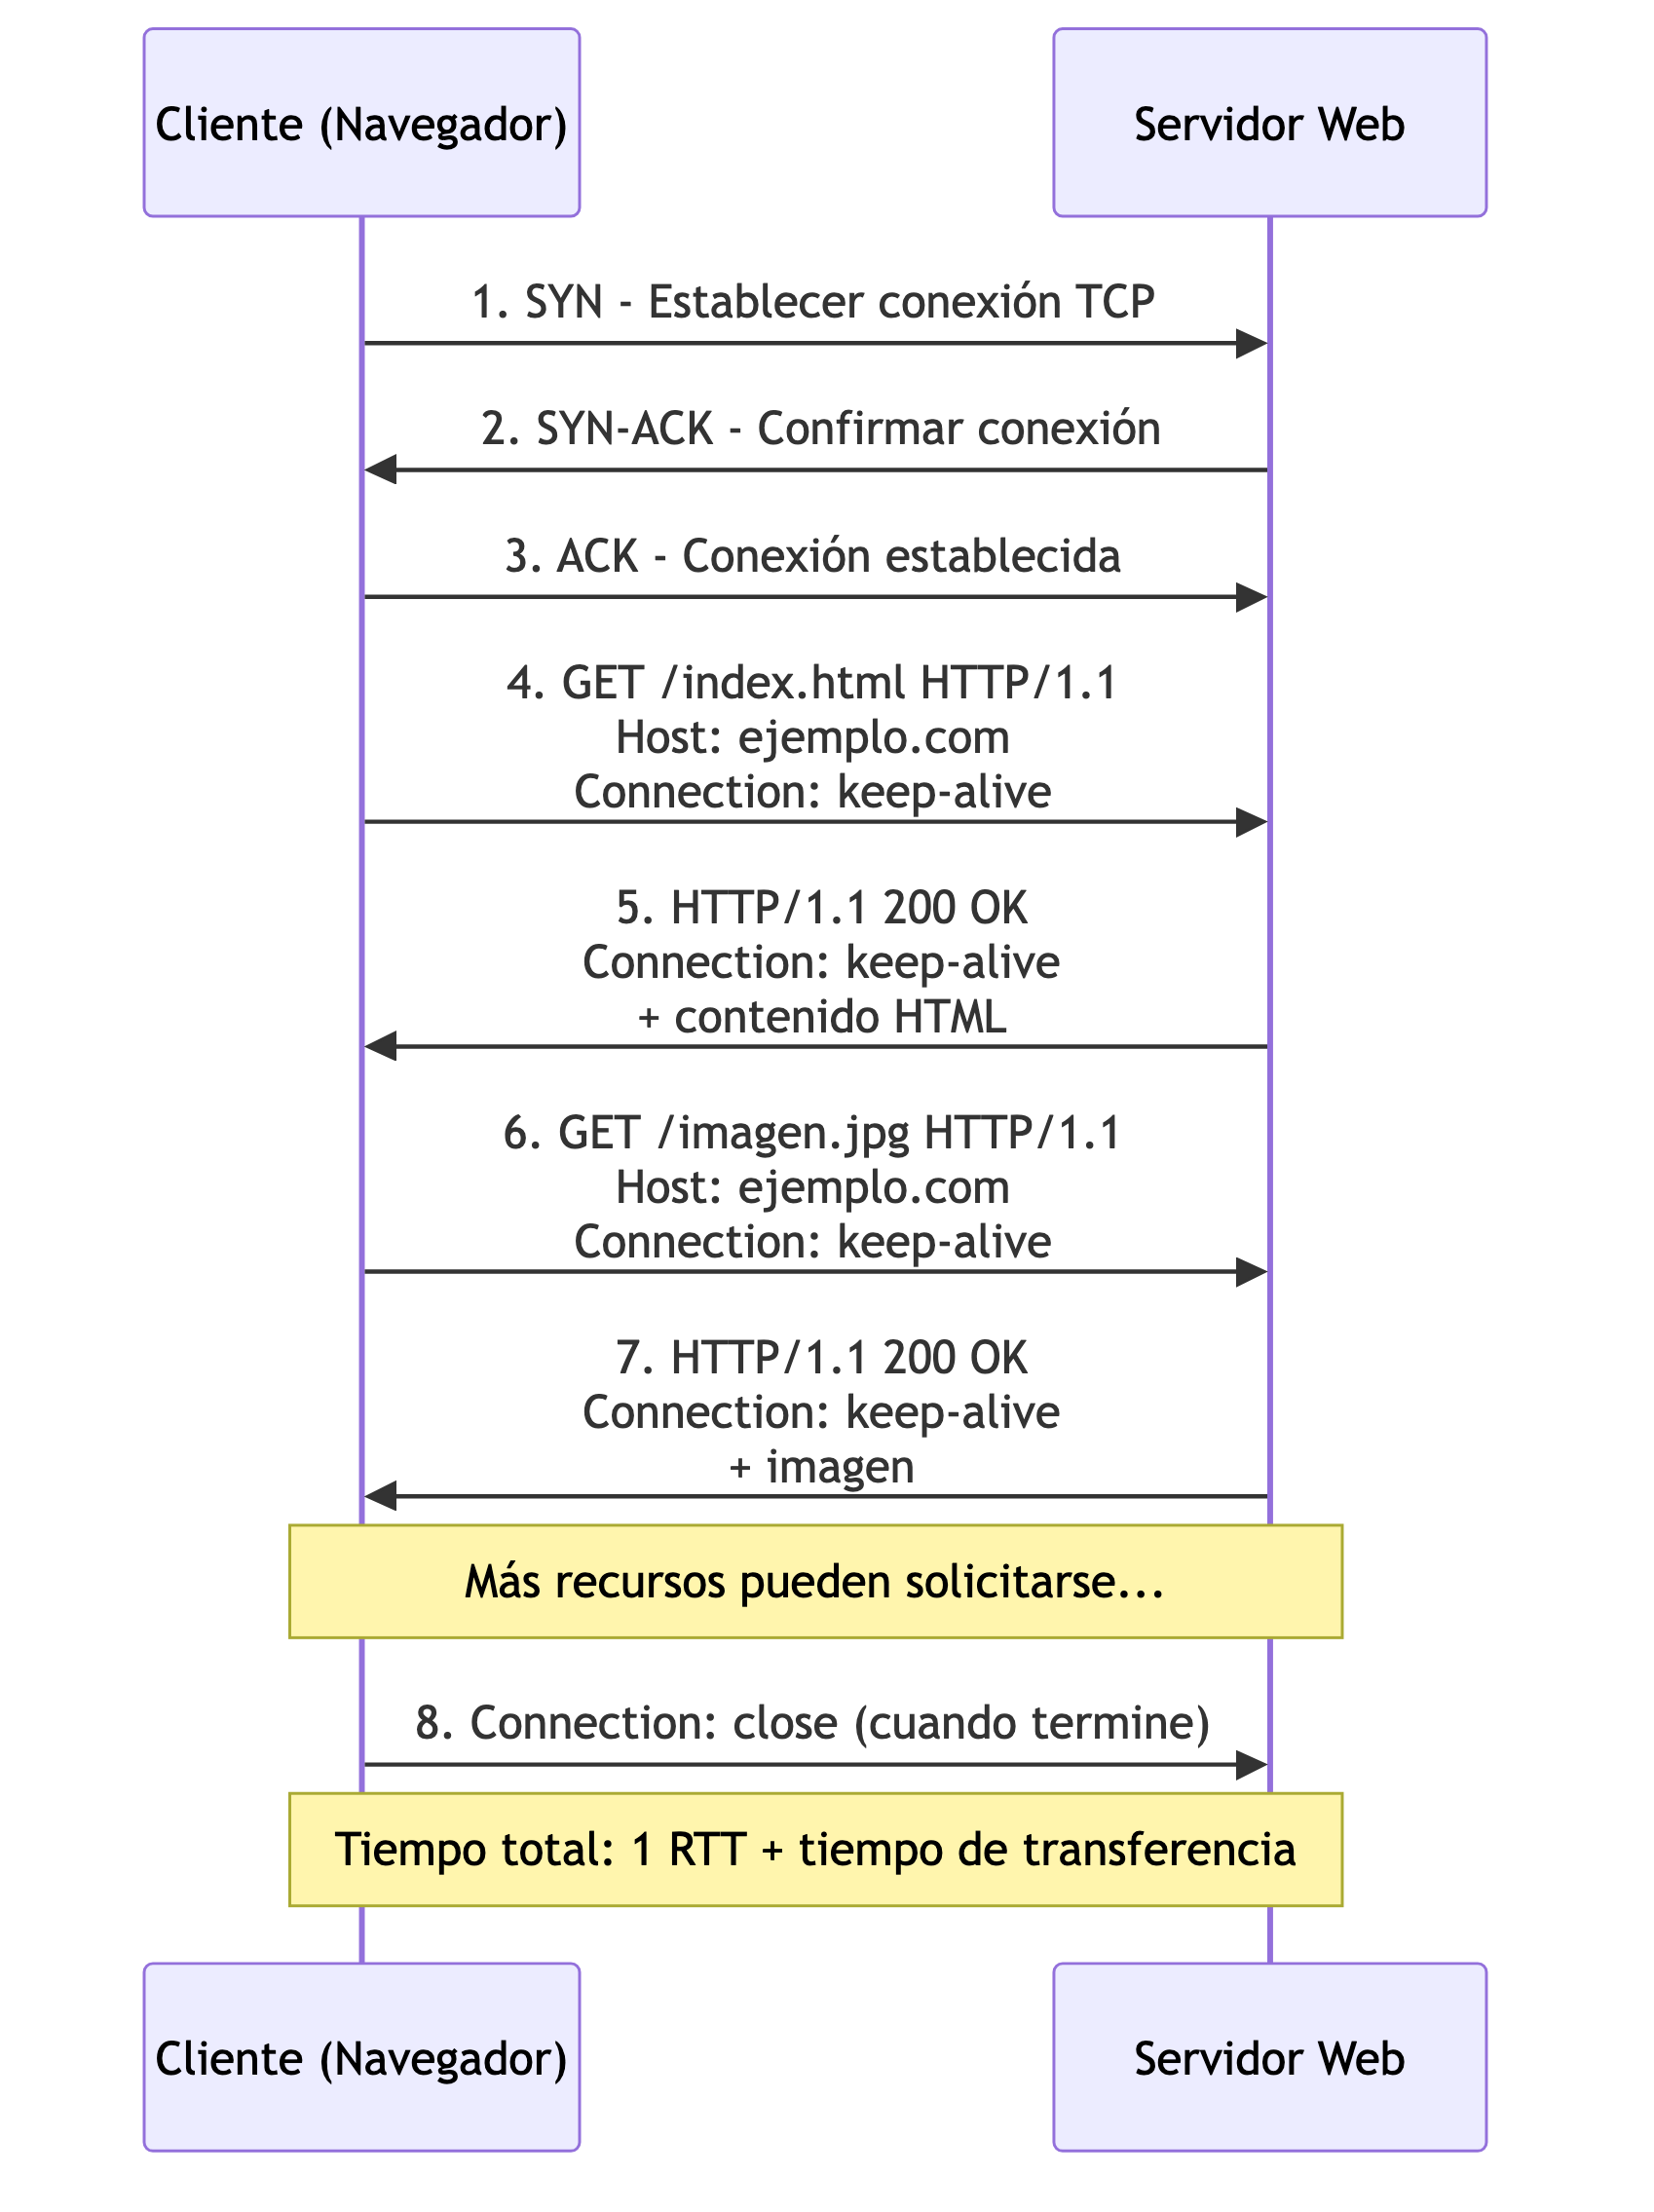
Dependiendo de la versión de HTTP se utilizarán diferentes tipos de conexión para enviar las peticiones. En HTTP/1.0, se utilizaban conexiones no persistentes, y para cada recurso se creaba una nueva conexión, incurriendo en un retardo de 2 RTT por objeto y la sobrecarga de abrir y cerrar conexiones. A partir de HTTP/1.1, se utilizan conexiones persistentes, donde varios objetos pueden ser enviados en la misma conexión, y por lo tanto, teniendo un retardo de 1 RTT por objeto. La limitación que tenía HTTP/1.1, es que si uno de los recursos tardaba mucho, ralentizaba a los que iban detrás. Para solucionar este problema se utilizan múltiples streams independientes sobre una conexión, solucionando el problema de que un recurso bloquee a los posteriores.
Por último, tiene un mecanismo adicional, las cookies que permiten guardar información en forma de pares de clave valor en el cliente. Las cookies se pueden configurar utilizando el campo de respuesta de la petición. En general se utilizan para mantener sesiones, personalización, análisis o con fines publicitarios. Estas cookies pueden ser propias, cuando es de la web que estamos navegando, o de terceros, cuando es un servicio que utiliza la web. Además del par de clave valor, también incluyen una fecha de expiración y del dominio del servidor. Las cookies expiran cuando pasa la fecha de expiración, aunque también pueden ser permanentes. El dominio es por seguridad, ya que determinadas cookies sólo queremos que sean accedidas por su dominio, con el fin de evitar suplantaciones de identidad.
Existe una variante de HTTP denominada HTTPS (Secure HyperText Transfer Protocol) en la cual las peticiones y sus respuestas no van en texto plano y se ha convertido en el estándar de la Web. De hecho algunos navegadores avisan o requieren confirmación para acceder a sitios a través de HTTP.
El protocolo opera generalmente sobre TCP, pero a partir de HTTP/3 opera sobre QUIC, que es un protocolo que implementa mecanismos de comunicación fiables sobre UDP. HTTP/3 está soportado por la gran mayoría de los navegadores actuales, y el soporte en los servidores está creciendo.
En determinadas situaciones para disminuir el tiempo de las peticiones se utilizan servidores proxy. Los servidores proxy son unos intermediarios, que analizan las peticiones, si pueden resolverlas ellos contestan directamente, y si no contestan a través de la petición al servidor. Las ventajas es que se obtiene una navegación más rápida, se reduce el tráfico, y además ganamos seguridad y anonimato. Suelen estar localizados en los navegadores (caché local), ISP o CDNs. En concreto, los servidores proxy cachean las peticiones GET, ya que es una operación segura y cacheable, y utilizan la herramienta del GET condicional donde en caso de que no haya actualización devuelve un 304 Not Modified (una respuesta sin cuerpo), ahorrando el tiempo de envío del recurso.
DNS
DNS (Domain Name System) es uno de los protocolos más importantes de Internet. El objetivo de DNS es simple, traducir identificadores textuales que sean fácil de recordar por humanos a direcciones IP. Por ejemplo, traducir “www.google.es” a 142.250.200.67. El sistema de DNS está diseñado como un sistema distribuido sin servidores centrales, lo que le permite distribuir la carga entre diferentes nodos y ser tolerante a fallos.
El sistema distribuido de DNS está formado por una estructura jerárquica de 4 tipos de nodos:
- Servidores raíz: Son las raíces de la jerarquía DNS y representan el nivel más alto del sistema. Existen 13 servidores raíz lógicos identificados con letras de la A a la M (a.root-servers.net hasta m.root-servers.net), aunque físicamente hay cientos de servidores distribuidos. Estos servidores conocen la ubicación de todos los servidores TLD y responden a consultas sobre dónde encontrar información de dominios de nivel superior.
- Servidores TLD (Top-Level Domain): Son responsables de los dominios de nivel superior como .com, .org, .net, .edu, y los dominios de país como .es, .mx, .ar. Mantienen información sobre qué servidores autoritativos son responsables de cada dominio específico dentro de su TLD.
- Servidores autoritativos: Contienen la información definitiva y oficial sobre un dominio específico. Son los que tienen la autoridad final sobre las zonas DNS que administran y proporcionan las respuestas definitivas sobre las direcciones IP de los hosts dentro de su dominio.
- Servidores locales: También llamados servidores recursivos o resolvers, son los que reciben las consultas directamente de los clientes (como tu computadora). Se encargan de realizar todo el proceso de resolución consultando a los diferentes niveles de la jerarquía DNS hasta obtener la respuesta final, que luego envían de vuelta al cliente. Suelen mantener una caché para mejorar la eficiencia.
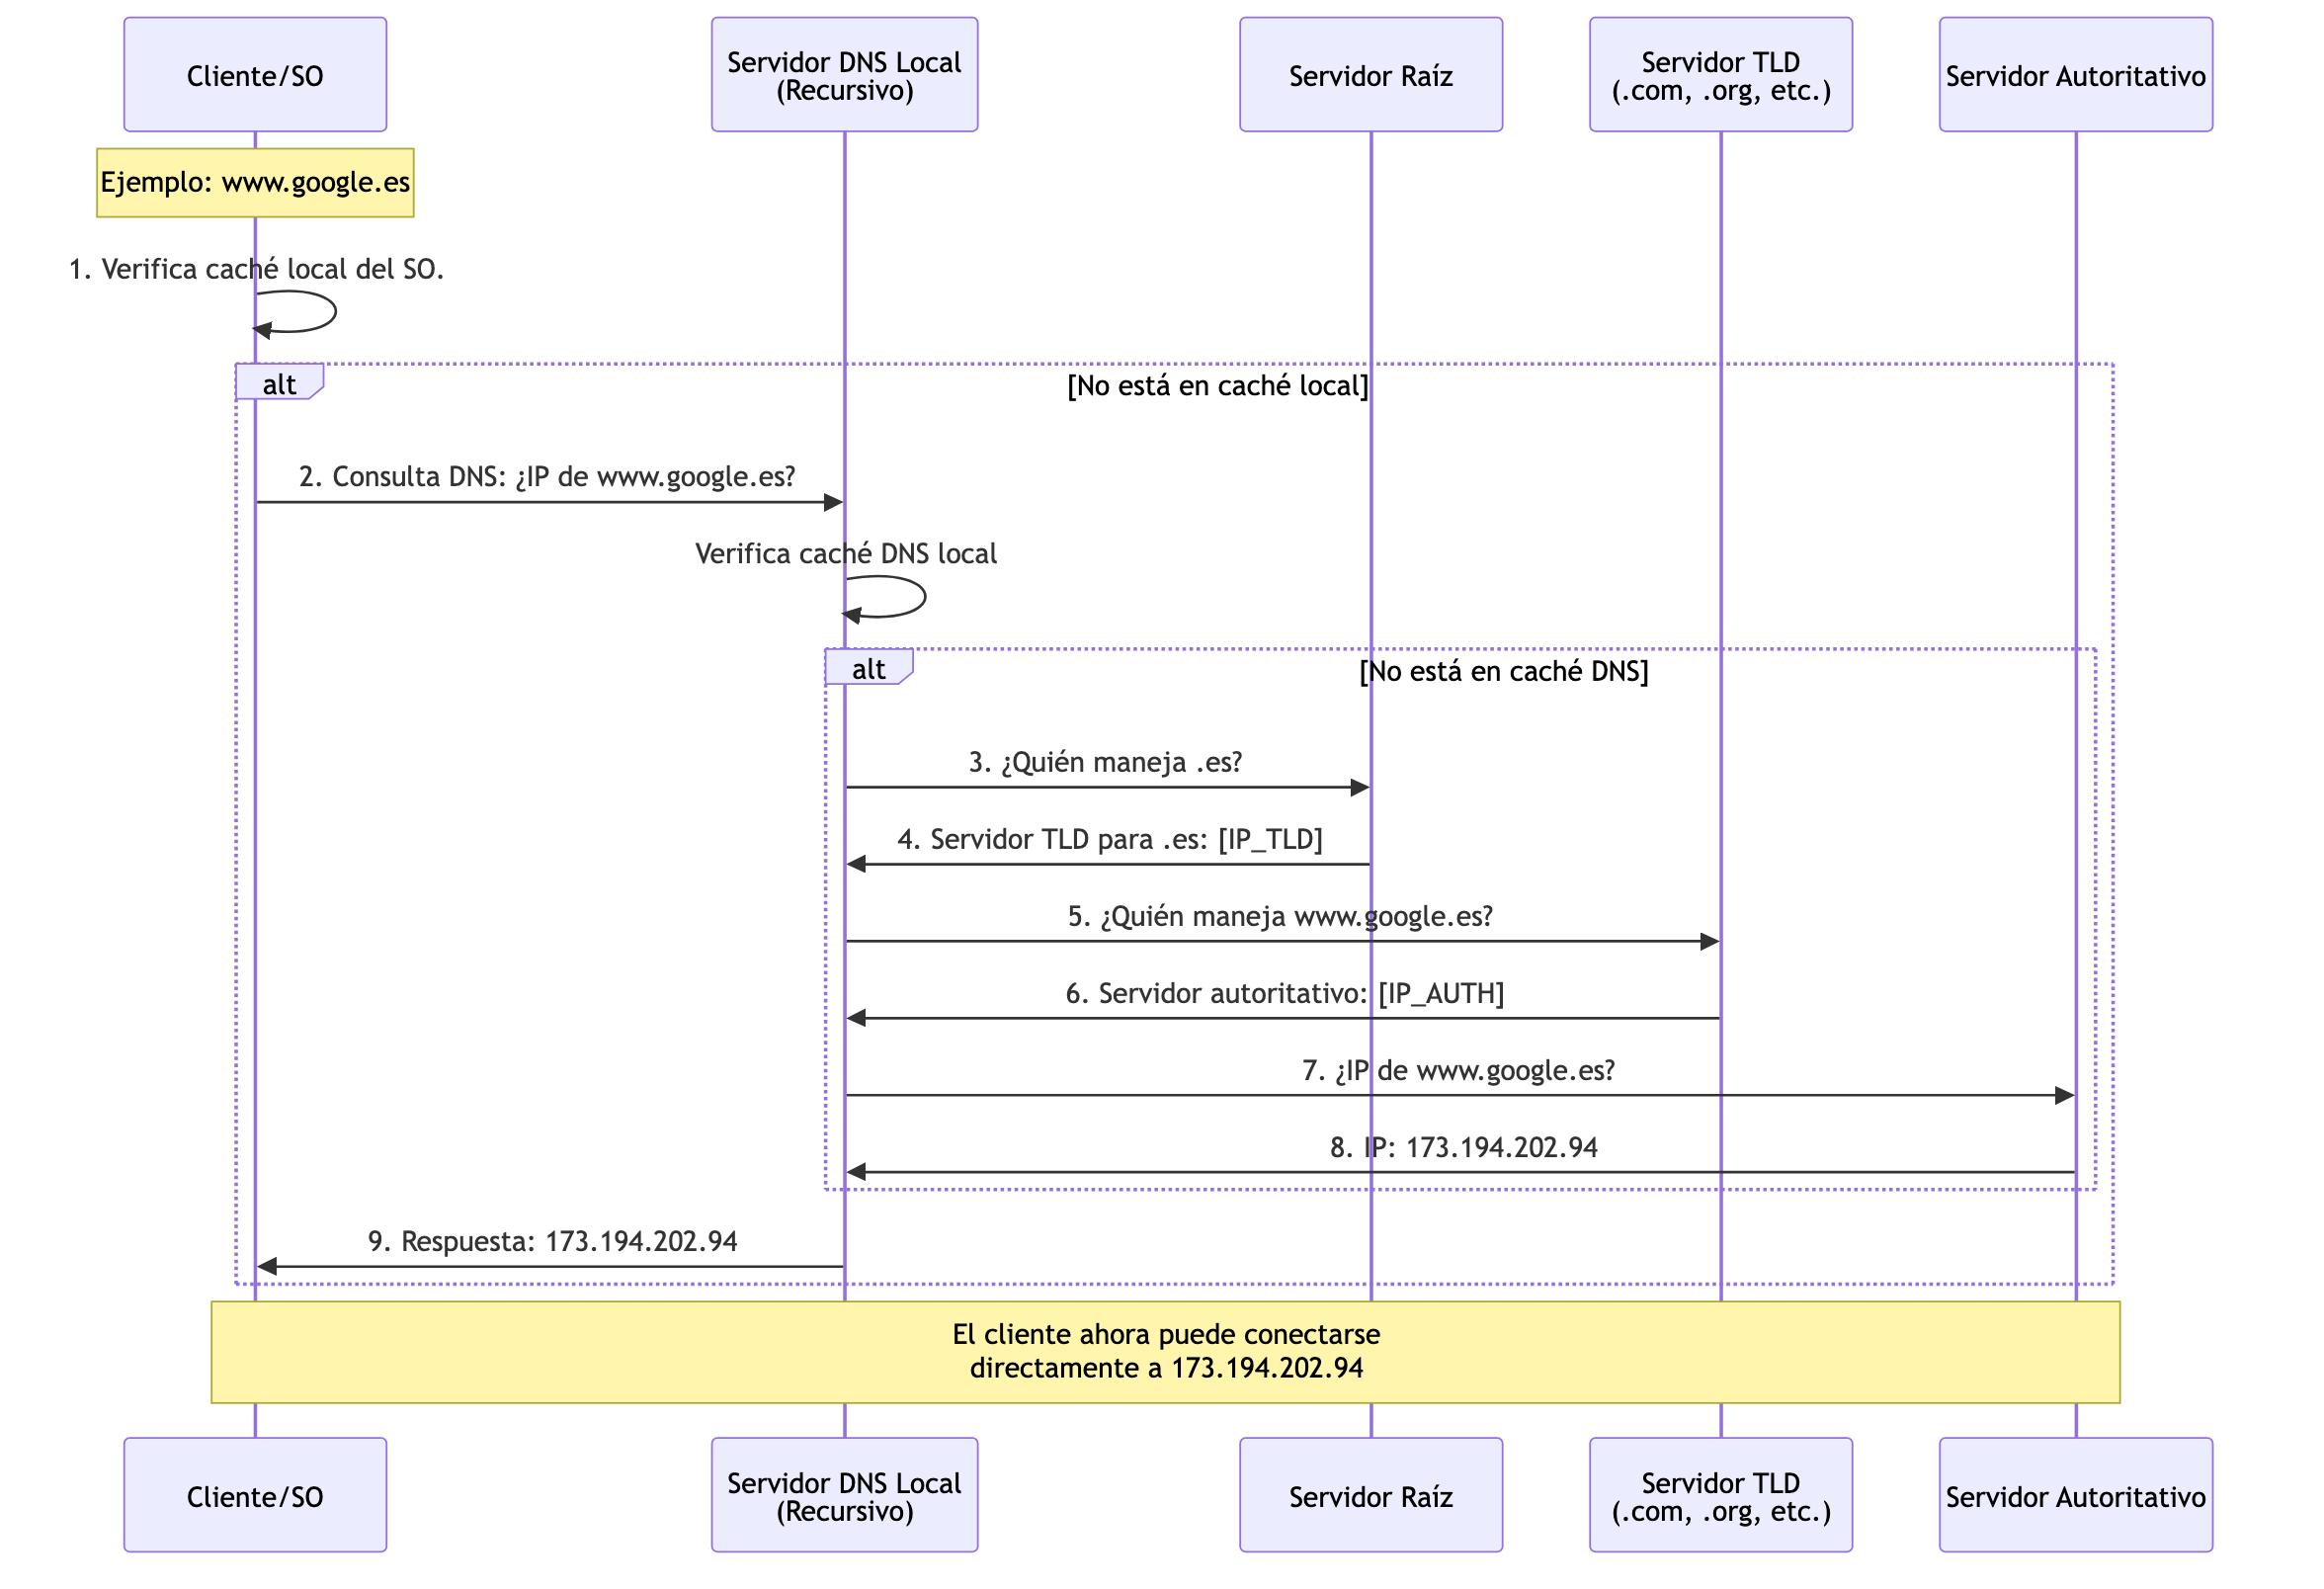
Para entender el proceso vamos a realizar un ejemplo de cómo sería la consulta para resolver el nombre de dominio www.google.es a una IP con DNS. El diagrama de secuencia lo podéis ver en la Figura 6.7. Los pasos para la resolución del DNS son los siguientes:
- Verificación de caché local del sistema operativo: Cuando escribes una URL en tu navegador, el sistema operativo primero verifica su caché local para ver si ya tiene almacenada la dirección IP correspondiente. Si la encuentra y no ha expirado, la utiliza inmediatamente sin necesidad de hacer consultas externas.
- Consulta al servidor DNS local: Si la información no está en caché o ha expirado, el cliente envía una consulta al servidor DNS configurado (generalmente proporcionado por tu ISP o servicios como 8.8.8.8 de Google). Esta consulta es recursiva, lo que significa que el cliente espera una respuesta completa.
- El servidor DNS local consulta al servidor raíz: El servidor DNS local, al no tener la información solicitada, inicia el proceso de resolución consultando a uno de los 13 servidores raíz. Le pregunta: “¿Quién maneja el dominio de nivel superior de este nombre?”
- Respuesta del servidor raíz: El servidor raíz no conoce la dirección IP específica, pero sí sabe qué servidor TLD maneja ese tipo de dominio (.com, .org, .es, etc.). Responde con la dirección del servidor TLD apropiado.
- Consulta al servidor TLD: El servidor DNS local ahora consulta al servidor TLD correspondiente preguntando: “¿Qué servidor autoritativo maneja este dominio específico?”
- Respuesta del servidor TLD: El servidor TLD responde con la información del servidor autoritativo responsable del dominio consultado. Por ejemplo, si buscas www.ejemplo.com, te dirá cuál es el servidor autoritativo para ejemplo.com.
- Consulta al servidor autoritativo: Finalmente, el servidor DNS local consulta al servidor autoritativo del dominio, que tiene la información definitiva sobre todos los registros de ese dominio.
- Respuesta del servidor autoritativo: El servidor autoritativo responde con la dirección IP correspondiente al nombre solicitado (registro A) o la información solicitada según el tipo de consulta.
- Respuesta final al cliente: El servidor DNS local almacena la respuesta en su caché (con un tiempo de vida o TTL específico) y envía la dirección IP al cliente que originó la consulta.
SMTP, IMAP y POP
Los protocolos SMTP, IMAP y POP son protocolos que definen el funcionamiento del correo electrónico tal y como lo conocemos hoy en día. Cada uno tiene un propósito específico en el proceso de envío, almacenamiento y recuperación de mensajes.
SMTP es el protocolo estándar para el envío de correos electrónicos a través de Internet. Funciona como un servicio de entrega que transporta mensajes desde el cliente de correo del remitente hasta el servidor de correo del destinatario. Es un protocolo “push”, empuja los mensajes desde el origen hacia el destino, y no maneja la recepción de los correos.
POP, especialmente POP3 (la versión más actual), es un protocolo para descargar correos electrónicos desde el servidor al dispositivo local. POP descarga los mensajes completos al dispositivo local, y por defecto, elimina los mensajes del servidor tras la descarga. Es ideal para usuarios que acceden al correo desde un único dispositivo, pero presenta limitaciones para sincronización entre múltiples dispositivos.
IMAP es un protocolo más moderno que permite acceder a los correos electrónicos manteniendo la sincronización entre el servidor y múltiples clientes. Los mensajes permanecen en el servidor y permite sincronización en tiempo real entre dispositivos. Soporta carpetas, etiquetas y búsquedas en el servidor. Es ideal para usuarios que acceden al correo desde múltiples dispositivos.
QUIC
QUIC representa una evolución revolucionaria en los protocolos de transporte de Internet, desarrollado inicialmente por Google en 2012 y estandarizado por la IETF en 2021 como RFC 9000. Este protocolo moderno construido sobre UDP combina las mejores características de TCP con la seguridad integrada de TLS 1.3, eliminando muchas de las limitaciones históricas de los protocolos tradicionales. Sus principales ventajas incluyen el multiplexado nativo de streams sin el problema de head-of-line blocking que afecta a HTTP/2 sobre TCP, el establecimiento de conexiones con latencia cero (0-RTT) para reconexiones, y la capacidad única de migración de conexión que permite a los dispositivos cambiar transparentemente entre redes WiFi y móviles sin interrumpir las sesiones activas. Además, QUIC incorpora algoritmos de control de congestión más sofisticados que mejoran significativamente el rendimiento en condiciones de red inestables o con alta pérdida de paquetes.
Los casos de uso de QUIC son especialmente relevantes en aplicaciones que requieren baja latencia y alta confiabilidad, siendo adoptado masivamente por servicios de streaming, aplicaciones de videoconferencia, juegos en línea, y plataformas de contenido como YouTube, donde Google reporta reducciones de hasta 30% en tiempo de carga. Su adopción ha alcanzado cifras impresionantes: HTTP/3 (que funciona exclusivamente sobre QUIC) se usa en aproximadamente un tercio de los sitios web y lo soportan todos los navegadores principales.
6.4 Servicios
CDNs
Las CDN funcionan mediante una red distribuida de servidores edge ubicados estratégicamente en diferentes regiones geográficas, que almacenan copias del contenido desde los servidores origen para reducir la distancia física que deben recorrer los datos hasta llegar al usuario final. El sistema utiliza enrutamiento inteligente que automáticamente dirige cada solicitud al servidor más cercano disponible, típicamente reduciendo la latencia de carga de 200-500ms a menos de 50ms. La estrategia de caché varía según el tipo de contenido: archivos estáticos como imágenes, vídeos y assets de aplicaciones se almacenan por períodos prolongados (días o semanas), mientras que contenido dinámico como respuestas de APIs se cachea por minutos u horas con validación frecuente. Para contenido personalizado, las CDN implementan técnicas de caché parcial donde elementos comunes se reutilizan entre usuarios, y para streaming en tiempo real dividen el contenido en pequeños segmentos que pueden cachearse individualmente.
Más allá de la simple entrega de contenido, las CDN modernas actúan como una capa de protección y optimización que incluye compresión automática de archivos, conversión de formatos de imagen según el dispositivo del usuario, y balanceado de carga inteligente que redistribuye el tráfico cuando algún servidor se sobrecarga. En aplicaciones como videojuegos, las CDN aceleran la descarga de actualizaciones y assets mediante técnicas de pre-carga predictiva, mientras que para aplicaciones web ejecutan código simple directamente en los servidores edge para personalización básica sin necesidad de consultar el servidor origen. La arquitectura distribuida proporciona resistencia natural contra caídas de servicio y ataques DDoS, ya que el tráfico malicioso se dispersa automáticamente entre múltiples ubicaciones, y sistemas de monitoreo en tiempo real pueden redirigir usuarios desde servidores con problemas hacia alternativas saludables, manteniendo la disponibilidad del servicio incluso durante fallas regionales o ataques coordinados.
Dos máquinas pueden tener diferente endianness (orden de bytes): big-endian almacena el byte más significativo primero, mientras que little-endian lo guarda al final. Los protocolos de red usan network byte order (big-endian) para garantizar que ambas máquinas interpreten los datos correctamente, independientemente de su arquitectura interna.↩︎
En realidad son para sistemas distribuidos. Pero las aplicaciones de red son inherentemente sistemas distribuidos.↩︎